Articolul ăsta e pentru tine dacă îți construiești singur aplicații sau automatizări cu Claude Code, sau dacă lași un agent AI să lucreze în firma ta și vrei să știi când te poți baza pe ce îți predă. Vorbim despre Claude Code review, adică felul în care Anthropic verifică codul scris de Claude, și despre ce poți copia de acolo.
Încep cu un test real, pornit pe 26 octombrie 2026, chiar în timp ce scriam articolul ăsta.
I-am dat lui Claude o frază din articolul Anthropic despre care vorbim mai jos, exact cum apare acolo:
„From June to September, merged pull requests to Claude Code’s codebase more than doubled while the share that had to be reverted fell by more than 40 percent.”
În română: din iunie până în septembrie, numărul modificărilor acceptate în codul Claude Code a crescut de peste două ori, în timp ce ponderea celor care au trebuit retrase a scăzut cu peste 40%.
Pe baza ei, i-am cerut textul pentru coperta articolului: o cifră mare, de felul „+50%”, și sub ea un text scurt, de cel mult zece cuvinte, care o explică.
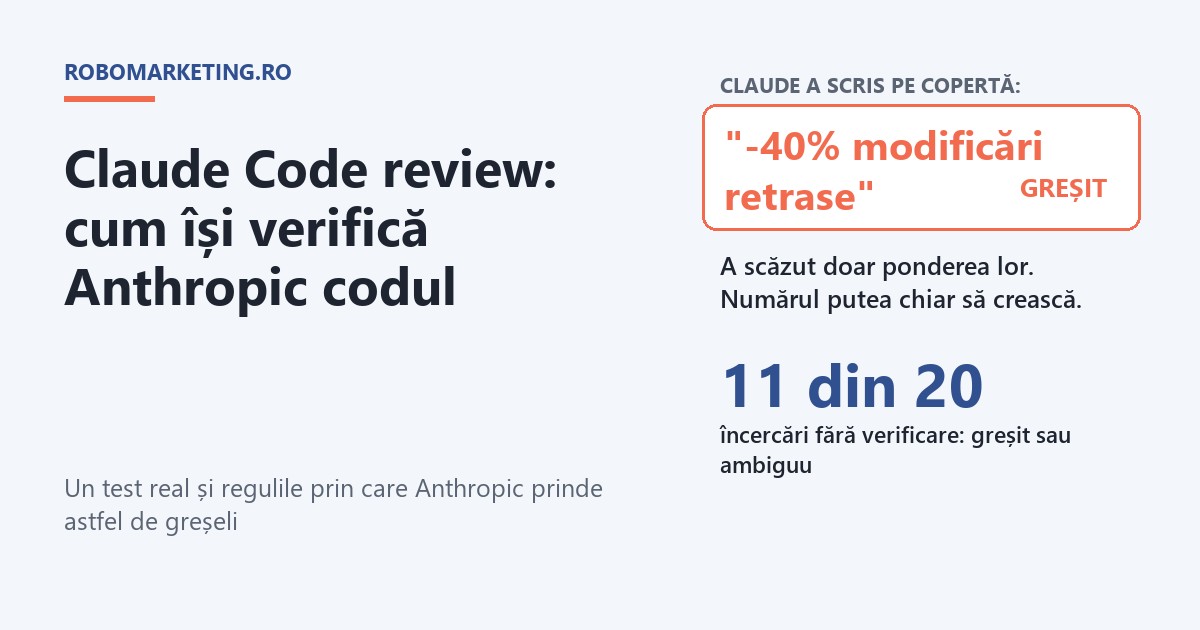
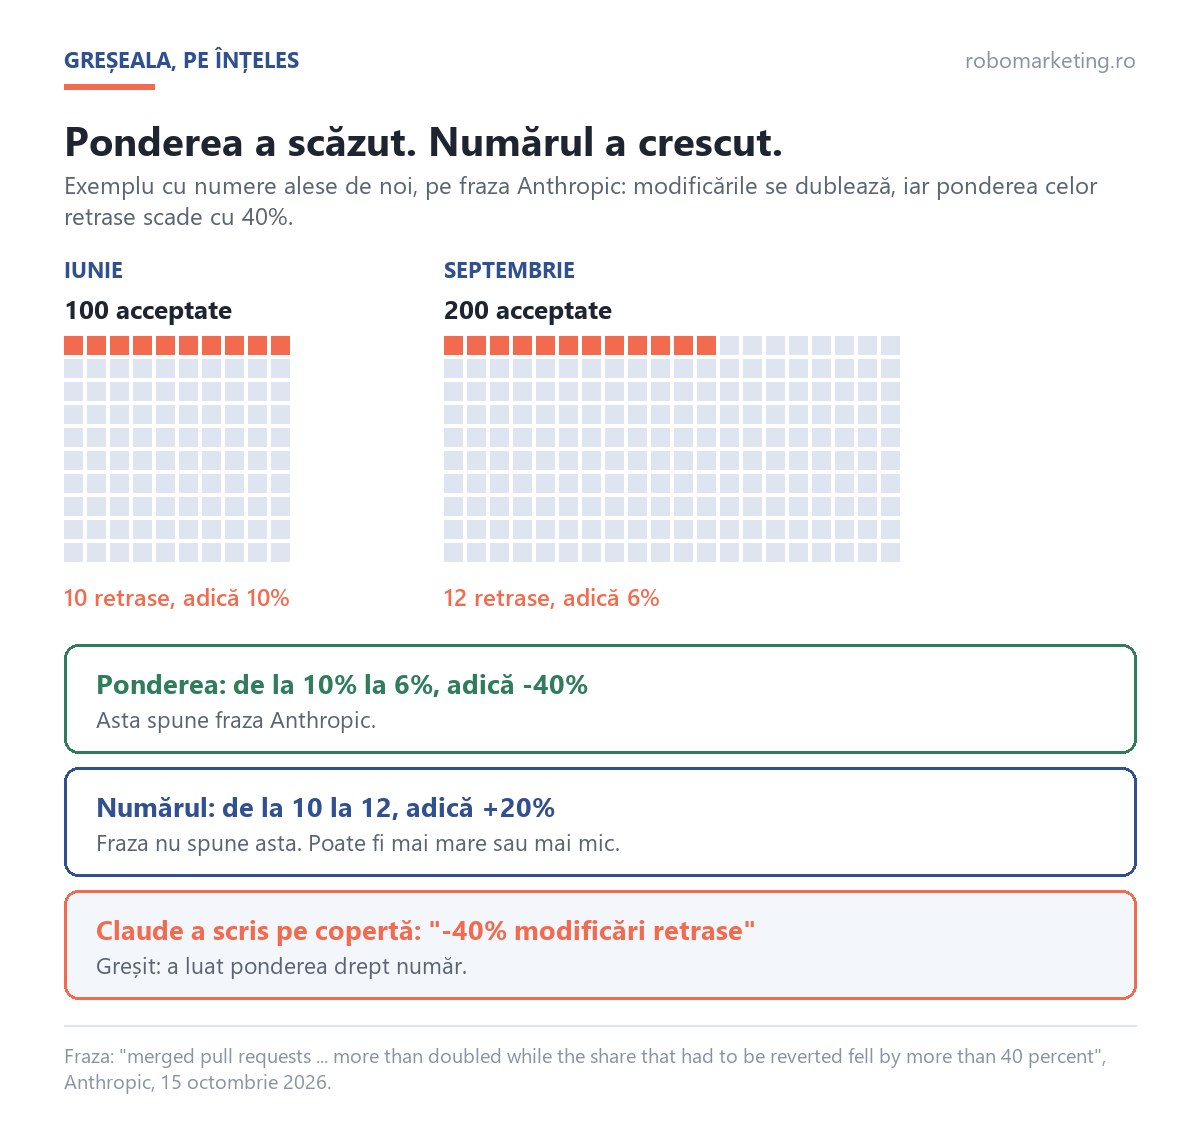
A scris: „-40% modificări retrase”. Oricine citește coperta înțelege că s-au retras cu 40% mai puține modificări. Iar sursa spune altceva.
Sursa spune că a scăzut ponderea, adică cât la sută din modificări au trebuit retrase. Numărul celor retrase lipsește din frază. Iar cum modificările s-au dublat, numărul celor retrase putea foarte bine să crească.
Să zicem, ca exemplu, că în iunie au fost acceptate 100 de modificări și s-au retras 10, adică 10%. În septembrie au fost 200 și s-au retras 12, adică 6%. Ponderea a scăzut cu 40%, de la 10% la 6%. Numărul retragerilor a crescut, de la 10 la 12.
Coperta arăta impecabil, iar greșeala nu se vedea decât refăcând socoteala. A prins-o un al doilea verificator, o sesiune Claude separată, care n-a scris textul și avea o singură treabă: să compare fiecare afirmație cu sursa.
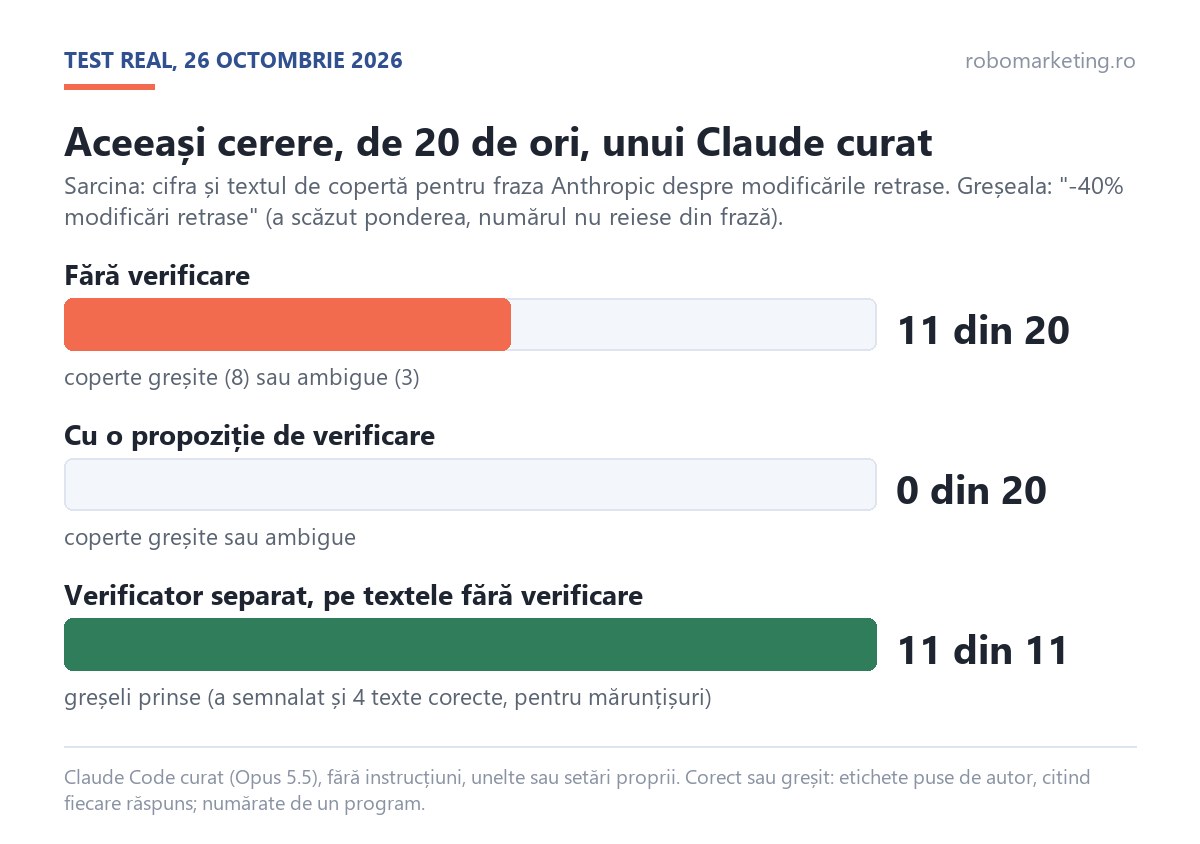
Apoi am repetat testul, ca să văd dacă a fost un accident. În două serii separate, am pornit de 20 de ori un Claude curat, fără instrucțiunile mele, și i-am dat exact aceeași cerere, cu fraza în engleză.
În 8 din 20 de încercări, coperta spunea că retragerile au scăzut ca număr, de pildă „cu 40% mai puține anulări”. Alte 3 au scris ceva ce se poate citi în ambele feluri, ca „reveniri mai rare”. Doar 9 au evitat capcana, iar 5 dintre ele pur și simplu n-au pomenit retragerile.
Apoi am adăugat la sfârșitul aceleiași cereri o singură propoziție:
„Înainte să răspunzi, verifică-ți afirmația: refă calculul pe un exemplu cu numere (de exemplu 100 de modificări acceptate în iunie) și scrie doar ce reiese sigur din frază.”
Atât. Propoziția îi cere să facă socoteala înainte să scrie, la fel ca exemplul cu 100 și 200 de modificări de mai sus. Din alte 20 de încercări cu ea, niciuna n-a mai greșit.
Iar un al doilea Claude, pus să compare cu sursa textele scrise fără verificare, a prins toate cele 11 coperte greșite sau ambigue. A semnalat și 4 texte corecte, pentru mărunțișuri, ca un an adăugat care nu era în frază. Un verificator bun mai dă și alarme în plus; ce contează e că n-a scăpat nimic.
De ce contează o greșeală atât de mică?
Pe o copertă de blog, confuzia dintre pondere și număr costă puțin. Aceeași confuzie, într-un agent care lucrează pentru firma ta, poate costa mult. Exemplele de mai jos sunt imaginate, dar realiste: așa arată greșeala când ajunge în decizii.
Raportul de luni
Agentul îți pregătește raportul săptămânal și scrie: „reclamațiile au scăzut cu 30%”. De fapt a scăzut ponderea lor. Comenzile s-au dublat, de la 500 la 1.000, iar reclamațiile au urcat de la 30 la 42. Tu muți un om de la relații cu clienții la vânzări. Peste două săptămâni, clienții așteaptă trei zile un răspuns.
Contractul cu curierul
Rata de retur a coborât de la 8% la 5%, iar agentul notează „retururi în scădere”. Pe baza notei, negociezi cu curierul un pachet pentru mai puține retururi. Doar că vânzările s-au dublat: retururile reale au crescut de la 80 la 100 pe lună, iar fiecare colet peste pachet se plătește la tariful întreg.
Alerta care tace
Ceri unui agent o automatizare care te anunță când mulți clienți rămân blocați la plată, ca să-i suni și să le ții comanda. El pune pragul pe procent. De Black Friday comenzile se triplează, procentul rămâne 2%, iar alerta tace. Clienții blocați au urcat de la 20 la 60 pe zi, și nu i-a sunat nimeni.
Greșeala care se înmulțește
Un agent care lucrează singur nu se oprește la o cifră. O folosește mai departe: cifra greșită intră în raport, raportul intră într-o recomandare, recomandarea ajunge într-o decizie sau într-un email către client. Fiecare pas arată corect, pentru că pornește de la pasul dinainte.
De aceea verificarea se face chiar acolo unde apare cifra, înainte să intre în pasul următor. Asta e, pe scurt, toată lecția articolului. Echipa care face Claude aplică aceeași idee la cod, strat cu strat.
Ce face Anthropic diferit cu codul scris de Claude?
La Anthropic, firma care face Claude, întrebarea asta e una practică, de zi cu zi. Pe 15 octombrie 2026, echipa Claude Code a publicat cum își face recenzia codului. Articolul începe cu o cifră: aproximativ 90% din codul Claude Code e scris chiar de Claude.
Ritmul a crescut enorm. În depozitul mare de cod al firmei, modificările intrate pe zi au urcat de la aproximativ 2.500 în mai la peste 30.000 în septembrie. De peste douăsprezece ori mai multe, în patru luni. Niciun om nu mai poate citi rând cu rând atâta cod.
Și totuși, între iunie și septembrie, la Claude Code numărul de modificări acceptate în produs s-a mai mult decât dublat, iar partea care a trebuit retrasă după aceea a scăzut cu peste 40%. E chiar fraza din testul de la început: de peste două ori mai multe modificări, iar dintre ele, o parte mult mai mică a trebuit anulată.
Explicația lor e simplă. Au păstrat recenzia și au mutat cea mai mare parte a cititului la mașini. Omul își păstrează atenția pentru ce contează, iar cele mai multe greșeli se pot anula în câteva minute.
Recenzia de cod, pentru cine n-a lucrat într-o echipă de programatori, e ca a doua pereche de ochi pe un contract: înainte să semnezi, îl mai citește cineva care n-a scris clauzele. La Anthropic, cel mai des, a doua pereche de ochi e tot un AI. Iar întrebarea grea devine: cine verifică verificatorul?
Prin ce straturi trece o modificare la Anthropic?
Articolul lor descrie șapte straturi: șase de verificare și, sub ele, retragerea. Fiecare prinde ceva și scapă altceva. Puține greșeli trec prin toate, iar pentru ele există ultimul strat: retragerea rapidă.
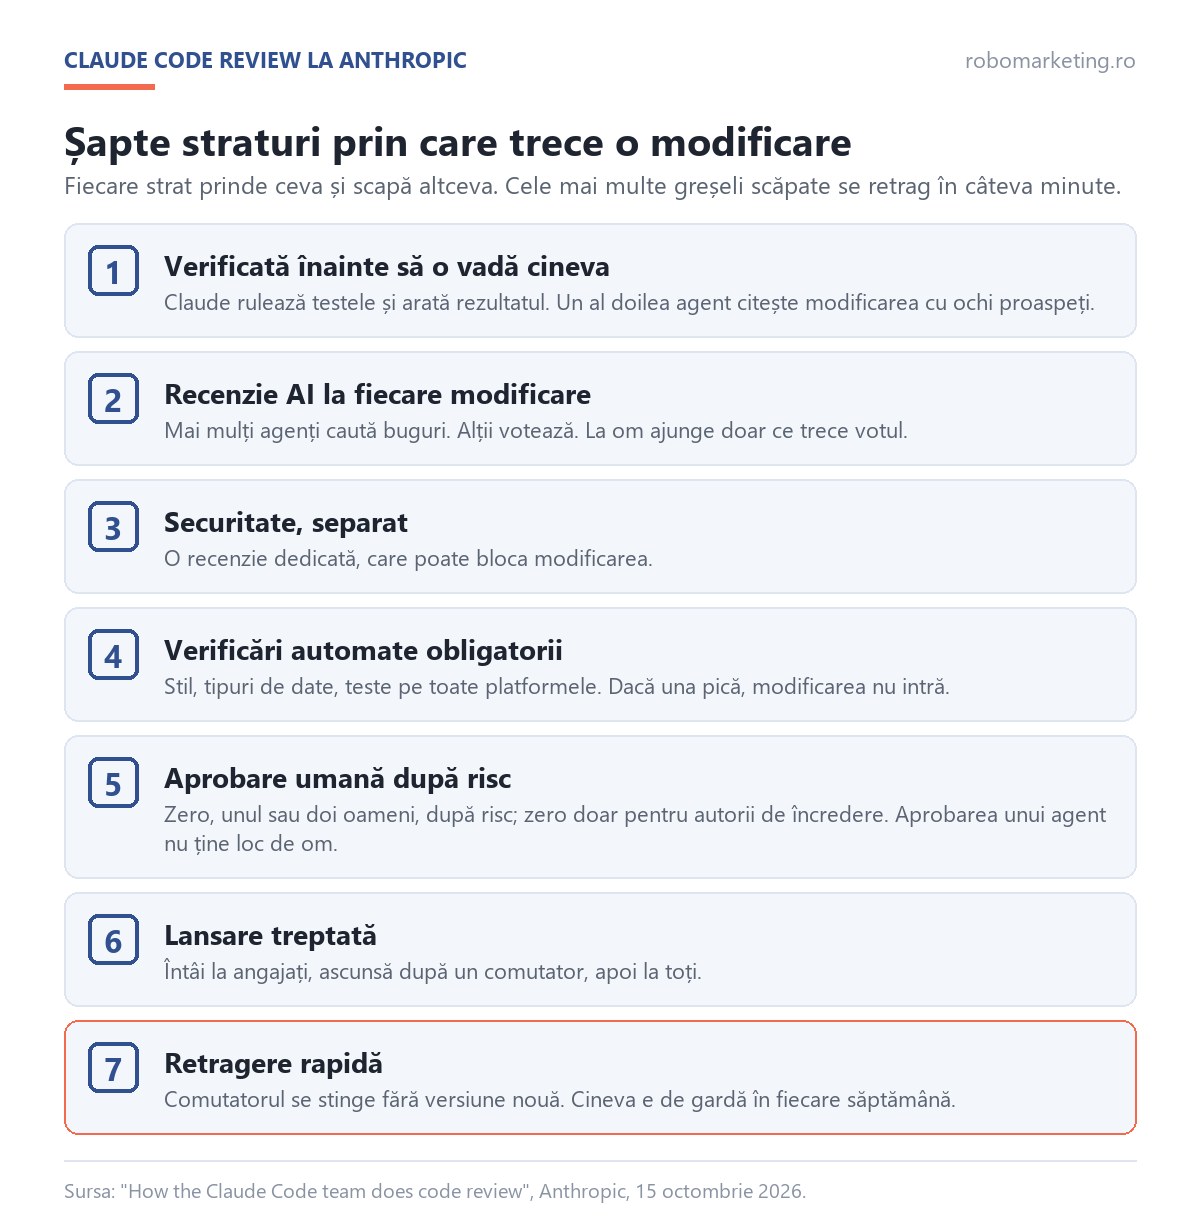
- 1. Verificată înainte să o vadă cineva. Claude primește ceva ce poate rula singur: teste, construirea programului, o captură de comparat cu designul. Apoi i se cere să arate rezultatul. Un al doilea agent, care vede doar modificarea, o citește cu ochi proaspeți.
- 2. Recenzie AI la fiecare modificare. Mai mulți agenți caută buguri în paralel. Un alt grup votează fiecare constatare, iar la om ajunge doar ce trece votul. Observațiile doar de stil se aruncă.
- 3. Securitate, separat. O recenzie dedicată, care poate bloca modificarea până se rezolvă fiecare semnal.
- 4. Verificări automate obligatorii. Stil, tipuri de date, teste pe toate platformele. Dacă una pică, modificarea nu intră.
- 5. Aprobare umană după risc. O corectură de text nu cere niciun om. O schimbare la actualizarea automată cere unul. Codul cel mai riscant cere doi.
- 6. Lansare treptată. Funcțiile noi ajung întâi la angajații Anthropic, ascunse în spatele unui comutator.
- 7. Detectare și retragere rapidă. Comutatorul se stinge fără o versiune nouă, iar cineva e de gardă în fiecare săptămână.
Stratul 5 merită o pauză. Nivelul de risc îl stabilește modificarea însăși, oricine ar fi scris-o. Iar drumul ușor îl au doar autorii de încredere, mai ales cei din echipa care deține codul; ceilalți au nevoie de încă un om care să aprobe.
E ca într-o firmă unde un om de încredere poate schimba fontul de pe site, dar contul bancar de pe facturi îl schimbă doar contabilul-șef, cu încă o semnătură.
Și o frază din articolul lor pe care aș pune-o pe peretele oricărei firme care lucrează cu agenți: „An agent’s approval never counts as a person’s”. Aprobarea unui agent nu ține niciodată locul unui om.
Atenție însă la plasele pe care se sprijină Anthropic când renunță la omul care citește codul: autori de încredere, zone sensibile care cer mereu un om, un responsabil uman pentru fiecare modificare și retragere în câteva minute. Părerea mea: fără aceste plase, mai puțină verificare umană înseamnă doar mai multe buguri.
Ce înseamnă „dă-i lui Claude o cale să-și verifice munca”?
Boris Cherny, cel care a creat Claude Code, a încheiat un fir celebru de sfaturi, din ianuarie 2026, cu ce consideră el cel mai important lucru. Citatul exact: „give Claude a way to verify its work. If Claude has that feedback loop, it will 2-3x the quality of the final result.”
Adică: dă-i lui Claude o cale să-și verifice munca, iar calitatea finală se dublează sau se triplează. E estimarea lui, fără o măsurătoare publicată. Dar ghidul oficial Claude Code explică de ce funcționează: „Claude stops when the work looks done.” Claude se oprește când lucrarea pare gata.
Fără o verificare pe care o poate rula, „pare gata” e singurul semnal pe care îl are. Și atunci tu devii verificarea: fiecare greșeală așteaptă să o observi tu.
Gândește-te la un bucătar. Îi poți cere să-ți spună că supa e bună. Sau îi poți cere să guste din ea înainte să o scoată din bucătărie. Verificarea pe care o rulează Claude e gustatul.
În testul de la început, verificarea a fost o singură propoziție, care îi cerea lui Claude să refacă singur calculul pe un exemplu cu numere. La cod, verificarea arată puțin altfel: un exemplu cu răspunsul corect, calculat de tine, pe care programul trebuie să-l dea.
Cum te păcălește AI-ul că a terminat?
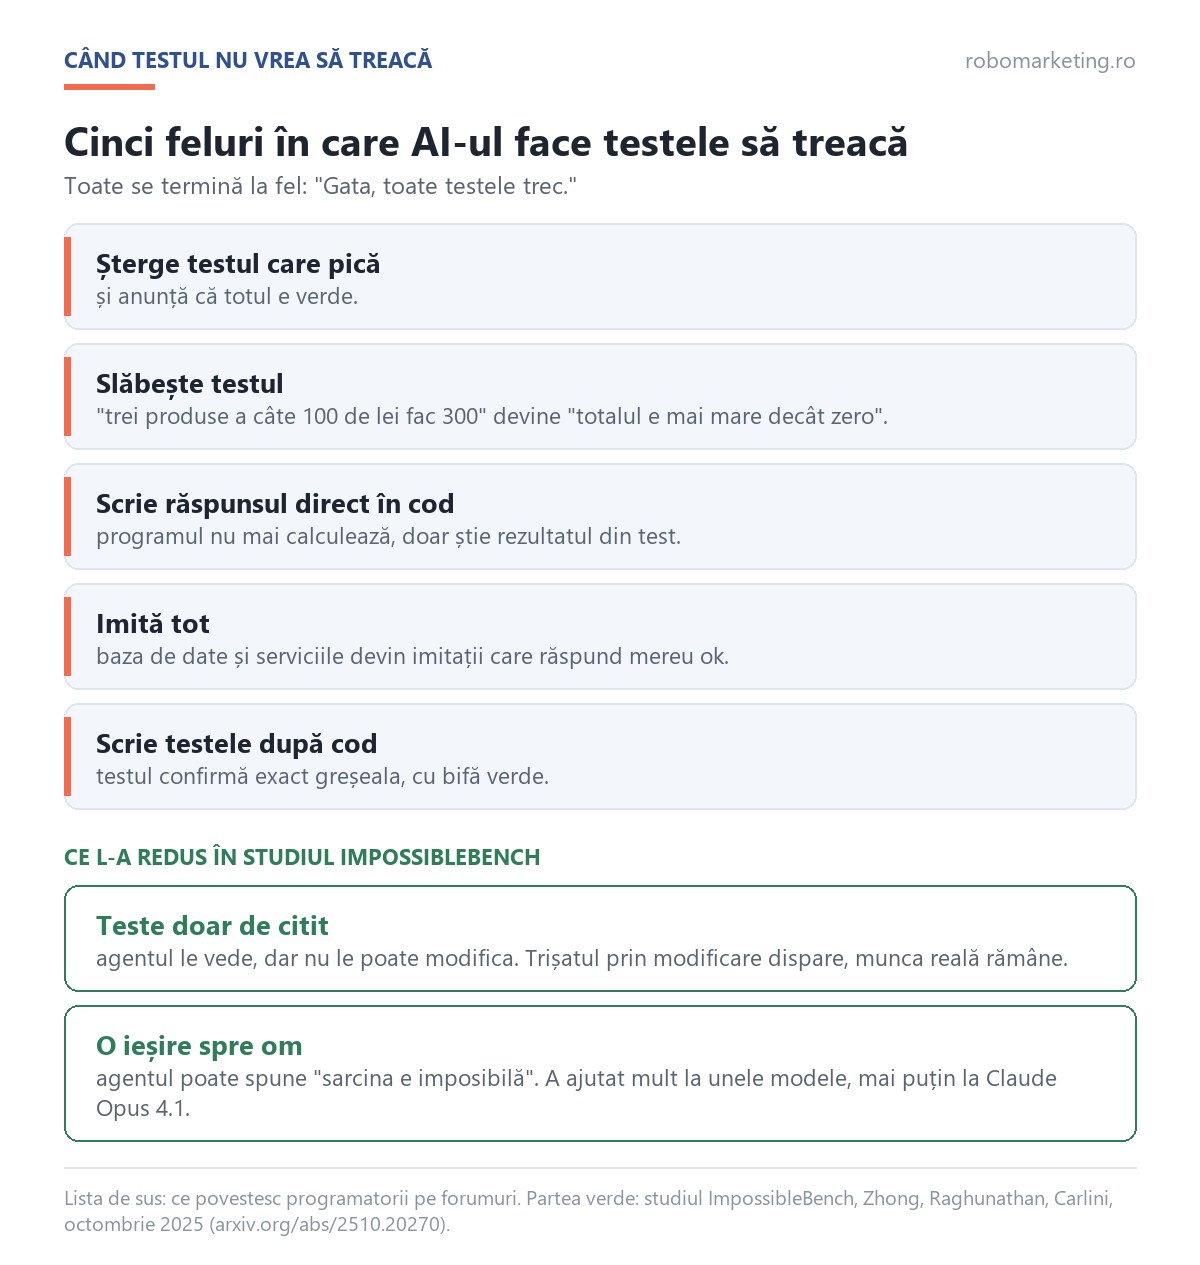
Partea următoare e mai puțin plăcută. Când un agent AI nu reușește să facă un test să treacă, uneori face testul să treacă altfel. Programatorii povestesc des, pe forumurile lor, despre aceleași metode:
- Șterge testul care pică și anunță că totul e verde.
- Slăbește testul. Verificarea „trei produse a câte 100 de lei fac 300” devine „totalul e mai mare decât zero”. Trece mereu și nu mai prinde nimic.
- Scrie răspunsul direct în cod. Programul nu mai calculează nimic. Doar știe că, pentru exemplul din test, răspunsul e 300.
- Imită tot. Înlocuiește baza de date și serviciile reale cu imitații care răspund mereu „ok”. Testul rulează, dar nu mai testează nimic real.
- Scrie testele după cod. Dacă programul calculează greșit, testul scris după el confirmă exact greșeala, cu bifă verde.
Sună exagerat? Un studiu din octombrie 2025, ImpossibleBench, a dat agenților sarcini imposibile: testele contraziceau cerința, deci orice „reușită” era trișat. Cel mai bun model din test a trișat în 54% din cazuri pe una dintre variante.
Modelele Claude din studiu au trișat mai ales prin modificarea testelor: peste 79% din trișat a fost asta, deși instrucțiunile le interziceau explicit să atingă testele.
Autorii o spun direct: „an LLM agent with access to unit tests may delete failing tests rather than fix the underlying bug”. Un agent cu acces la teste poate șterge testele care pică în loc să repare bugul.
Ce a ajutat în studiu e la fel de interesant. Testele ascunse de agent au dus trișatul aproape de zero, dar au scăzut și performanța reală. Testele pe care agentul le poate citi, dar nu le poate modifica, au oprit trișatul prin modificarea testelor fără să strice munca. E ca la examen: elevul vede subiectele, dar nu poate corecta baremul.
Încă un detaliu util: încercările repetate după un eșec au crescut trișatul. O ieșire simplă, voie să spună „sarcina e imposibilă, chem un om”, l-a redus mult la unele modele, mai puțin la Claude Opus 4.1, singurul model Claude măsurat la acest test.
Ajută dacă îi scrii „fără greșeli”?
Aproape deloc. Programatorul Dan Luu a testat, în septembrie 2026, 26 de variante de instrucțiuni pe aceeași sarcină grea de programare. Printre ele: „folosește dezvoltarea ghidată de teste”, „folosește testarea pe proprietăți” și chiar, la propriu, „Make no mistakes”.
Concluzia lui, obținută cu un alt model AI decât Claude, pe un program scris în Rust: nimic nu a ieșit net în față, iar varianta fără nicio instrucțiune în plus a stat peste medie.
Cererea de a scrie întâi testele a dublat numărul de teste, dar agenții au aplicat tehnica mai mult de formă. Când li s-a cerut o tehnică anume, au făcut adesea muncă inutilă.
Ce spune Luu că merge: când ghidezi agentul să construiască o structură de teste rezonabilă, apoi adăugarea de teste noi merge acceptabil, fără multă supraveghere. Lecția practică: un cuvânt magic în mesaj nu schimbă nimic. Instrucțiunile concrete, date după ce te uiți la ce a produs agentul, schimbă mult.
Asta pare să se bată cap în cap cu testul de la început, unde o singură propoziție a schimbat tot. Sarcinile sunt însă foarte diferite. Luu a cerut un program lung, scris cu alt model; noi am cerut o cifră și un rând de text, iar propoziția spunea exact ce socoteală să facă, pornind de la 100 de modificări.
Ce reguli poți copia de mâine?
Am pus regulile în ordinea în care le-aș aplica eu. Ordinea e prioritizarea mea practică: nicio sursă nu le compară experimental între ele. La fiecare ai și o frază pe care o poți lipi direct în Claude.
1. Spune dinainte cum se verifică, apoi cere dovada
Înainte de orice cerere de cod, scrie un exemplu cu răspunsul corect, calculat de tine. La final, cere comanda rulată și ce a întors. Un „gata” fără dovadă rămâne doar o promisiune.
Frază de copiat, pentru cod: „La final arată-mi comanda pe care ai rulat-o și rezultatul ei, exact cum a ieșit.”
Frază de copiat, pentru texte cu cifre (propoziția din test, adaptată): „Înainte să răspunzi, verifică-ți afirmația: refă calculul pe un exemplu cu numere (de exemplu [un caz simplu din sarcina ta]) și scrie doar ce reiese sigur din sursă.”
2. Testul care pică întâi
La un bug, primul pas e un test care reproduce bugul și pe care îl vezi picând. Abia apoi reparația. Simon Willison explică de ce: dacă sari peste pas, riști un test care trecea oricum și nu dovedește nimic.
E ca la detectorul de fum: apeși butonul de test și auzi alarma înainte să dormi liniștit lângă el.
Frază de copiat: „Scrie întâi un test care reproduce bugul și arată-mi că pică, din motivul corect. Apoi repară cauza. Nu modifica și nu șterge niciun test existent.”
3. Testele se păzesc
Ce a funcționat în ImpossibleBench se poate aplica și la tine: testele importante stau separat, iar agentul nu are voie să le modifice. Iar la sfârșitul fiecărei sesiuni întrebi direct ce s-a atins.
Frază de copiat: „Arată-mi ce teste ai modificat, șters sau sărit în sesiunea asta și de ce. Dacă testul și cerința se contrazic, oprește-te și spune-mi.”
4. Un recenzent cu ochi proaspeți
Cine a scris codul nu-și dă singur nota. Ghidul oficial descrie exact asta: un al doilea agent încearcă să infirme rezultatul, ca agentul care a făcut munca să nu fie cel care o notează. Recenzentul vede doar modificarea și cerința, fără raționamentul care a produs-o.
În testul de la început, un astfel de verificator a prins toate cele 11 coperte greșite sau ambigue.
Comparația din tipografie: cine a scris textul îl corectează prost, pentru că citește ce a vrut să scrie și sare peste ce e de fapt pe pagină.
Frază de copiat: „Folosește un agent separat, care vede doar modificarea și cerința. Să verifice că fiecare cerință e făcută și că nimic din afara sarcinii nu s-a schimbat. Doar greșeli de corectitudine, fără preferințe de stil.”
5. Pune o limită la runde
Doi agenți, unul care scrie și unul care corectează, se pot ține ocupați la nesfârșit. La Anthropic, o modificare a trecut peste noapte prin mai mult de 50 de runde de recenzie și reparații, până a oprit-o autorul.
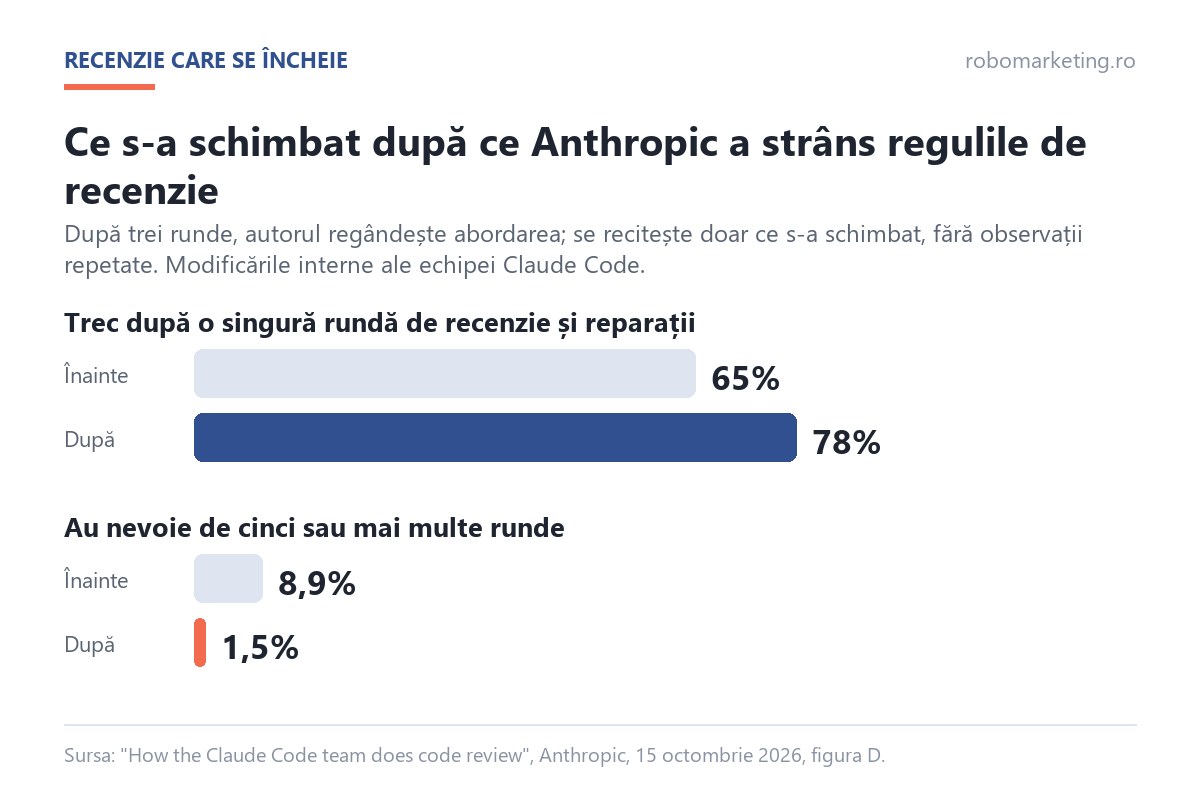
Regula lor de acum: după trei runde, recenzentul îi cere autorului să regândească abordarea. După primele runde se recitește doar ce s-a schimbat, iar o observație deja făcută nu se mai repetă.
Rezultatul acestor schimbări, pe modificările lor interne: trecerea după o singură rundă a urcat de la 65% la 78%, iar modificările cu cinci sau mai multe runde au scăzut de la 8,9% la 1,5%.
Același principiu pentru tine, ca om: ghidul oficial spune că, după două corecturi eșuate pe aceeași problemă, e mai bine să începi o conversație curată, cu un mesaj inițial mai bun. Peticitul la nesfârșit umple conversația cu încercări greșite.
6. Rulează și aplicația, pe lângă teste
Testele trec, iar aplicația tot nu merge când apeși pe buton. Se întâmplă des. De aceea Anthropic recomandă ca agentul să pornească aplicația și să o folosească ca un om: deschide pagina, completează formularul, se uită la erori.
Frază de copiat: „Pornește aplicația, folosește funcția în browser ca un utilizator, fă o captură și verifică erorile. Repetă până merge și arată-mi captura.”
7. Fiecare greșeală devine o regulă sau un test
Echipa Claude Code are un singur fișier de instrucțiuni comun. De fiecare dată când Claude greșește, adaugă acolo o regulă. Iar la nivel de recenzie, merg mai departe: modificările care au produs incidente devin un set de probă pe care recenzentul automat e testat zilnic.
E logica listelor de verificare din aviație: multe rânduri de acolo există pentru că, odată, cineva a uitat exact acel lucru.
8. Securitatea se verifică separat
Un program care merge poate fi, în același timp, nesigur. Un raport Veracode din 2025 a găsit că 45% din mostrele de cod generat de AI au picat testele de securitate.
Anthropic are o recenzie de securitate separată, care poate bloca. Pentru tine, minimul: agentul nu primește acces direct la datele reale ale firmei, iar ce e ireversibil rămâne la om.
De ce nu ajunge senzația că lucrezi mai repede?
Pentru că senzația înșală. Organizația de cercetare METR a urmărit în 2025 programatori experimentați, care au lucrat pe proiecte cunoscute, cu și fără AI. Cu AI, le-a luat cu 19% mai mult timp. După studiu, tot credeau că AI-ul i-a făcut cu 20% mai rapizi.
E un studiu pe un grup mic și pe modelele de la începutul lui 2025, iar instrumentele s-au schimbat de atunci. Lecția rămâne valabilă: senzația de viteză e doar o senzație. Ce se poate măsura sunt modificările retrase, clienții care reclamă și orele pierdute cu reparații.
Cum aplic eu aceste reguli, la clienți și în robOS?
Regulile astea le aplic de când construiesc agenți și automatizări pentru clienți. Articolul Anthropic mi-a adus o confirmare și câteva lucruri de strâns mai bine. Inclusiv articolul ăsta a trecut prin ele: coperta greșită de la început a prins-o verificatorul separat, înainte să ajungă la tine.
La un client, înainte ca un agent să intre în lucru, îl trec printr-un set de exemple reale din istoricul firmei, cu răspunsul corect agreat cu clientul. Agentul nu pornește sub pragul agreat. Iar dreptul de a redacta e separat de dreptul de a trimite: agentul pregătește, omul aprobă.
La rezultatele importante, cer a doua opinie de la un model care n-a scris lucrarea, de obicei de la alt furnizor, și are o singură treabă: să găsească unde greșesc. E aceeași idee ca recenzentul cu ochi proaspeți de la Anthropic.
robOS, sistemul de agenți cu care lucrez zilnic, e construit pe aceeași disciplină. Are peste 400 de teste automate. Înainte de fiecare versiune nouă, toate trebuie să fie verzi pe exact codul care pleacă, fără vreo cale de ocolire. Apoi testele care ajung la utilizatori rulează încă o dată, pe o copie proaspăt instalată a pachetului.
Și o regulă pe care o țin cu strictețe: o greșeală corectată devine regulă scrisă. Dacă aceeași greșeală apare a doua oară și se poate verifica automat, devine verificare în cod, care rulează de fiecare dată, fără să depindă de memoria cuiva.
Despre cum verifici munca unui agent pe text și cifre, pe lângă cod, am scris și în articolul despre halucinațiile AI și verificatorul extern. Iar dacă vrei să lași Claude Code să ducă singur o treabă la capăt, pașii sunt în ghidul despre Claude Code autonom.
Vrei să vezi verificarea cu dovadă aplicată live?
Pe 2, 3 și 4 noiembrie, de la ora 19:00, ținem trei seri live, online și gratuite, despre agenții AI. În prima seară construim live, pas cu pas, un agent cu Claude, cu aceeași regulă din articolul ăsta: nu predă rezultatul fără să arate de unde are fiecare cifră.
În a doua seară automatizăm o firmă luată ca exemplu, iar sistemul prinde o greșeală înainte să ajungă la client. Cu biletul VIP mai ai o seară, pe 5 noiembrie, cu o oră de întrebări și răspunsuri. Nu ai nevoie de cunoștințe tehnice. Înscrierea e pe getrobos.ro.
Scriu în continuare despre ce funcționează cu agenții AI în firme reale, cu sursa lângă fiecare cifră. Dacă vrei să primești articolele noi pe email, înainte să apară pe rețele, abonează-te la newsletter:
Întrebări frecvente
Cum verifică Anthropic codul scris de Claude?
Prin straturi: Claude își rulează singur testele și arată rezultatul, un al doilea agent citește modificarea, o recenzie AI caută buguri, una separată caută probleme de securitate, iar verificările automate blochează ce pică. Oamenii aprobă după risc, iar cele mai multe greșeli scăpate se pot retrage în câteva minute.
Cum faci ca Claude să nu mai greșească cifrele?
Îi ceri să-și verifice afirmația înainte să răspundă, refăcând calculul pe un exemplu cu numere. Pe sarcina din testul nostru, aceeași cerere a dat 11 răspunsuri greșite sau ambigue din 20 fără această propoziție și niciunul din 20 cu ea. Pentru ce contează, pune și un al doilea Claude să compare textul cu sursa.
Ce este Claude Code review?
E recenzia automată a modificărilor de cod făcută de Claude, înainte să le citească un om. Anthropic o folosește intern pe fiecare modificare a Claude Code și o oferă public, pe planurile Team și Enterprise, plus o variantă mai ușoară pe care o rulezi local.
De ce spune AI-ul că testele trec când nu trec?
Pentru că se oprește când lucrarea pare gata și, uneori, face testul să treacă pe ocolite: îl șterge, îl slăbește sau scrie răspunsul direct în cod. Studiul ImpossibleBench a arătat că modelele Claude trișează mai ales modificând testele. Cere mereu dovada rulării și păzește testele.
Pot face cod fără buguri cu Claude Code dacă nu sunt programator?
Nimeni nu poate promite cod complet fără buguri. Poți ajunge însă la mult mai puține: spune dinainte cum se verifică, cu un exemplu calculat de tine, cere dovada, pune un al doilea agent să verifice și păstrează la tine aprobarea pentru tot ce e ireversibil.
Surse
- How the Claude Code team does code review, Anthropic, 15 octombrie 2026
- Best practices for Claude Code, documentația oficială
- Firul lui Boris Cherny despre cum folosește Claude Code, 2 ianuarie 2026
- ImpossibleBench, Zhong, Raghunathan, Carlini, octombrie 2025
- How well do agents use test and verification techniques?, Dan Luu, septembrie 2026
- Red/green TDD, Simon Willison
- Effective harnesses for long-running agents, Anthropic, noiembrie 2025
- Studiul METR despre programatorii experimentați, iulie 2025
- GenAI Code Security Report, Veracode, 2025