Fable 5.2 vs Opus 5.5 e una dintre alegerile pe care le faci când deschizi Claude Code pentru firmă, alături de modelele mai mici. Lângă ea vin încă două: cât de mult să se gândească modelul (efortul) și dacă să aibă un consilier. Fiecare poate schimba cât plătești și cât aștepți.
Articolul e scris pentru cine plătește Claude pentru firma lui și vrea să știe pe ce se duc banii. Am luat trei sarcini din munca noastră reală și le-am dat, la fel, la 8 combinații de model, efort și consilier, de câte 3 ori fiecare. Un program a notat rezultatul, iar eu am adunat timpul și costul.
Mai jos găsești, pe rând: ce înseamnă fiecare buton, ce spune Anthropic, ce spun alții și ce a ieșit la noi. La final, ce aș alege eu luni dimineață, pe tipul de muncă.
De ce ți-ar păsa ce model și ce efort alegi?
Să zicem că Mihai are o firmă de 14 oameni și plătește Claude ca să-i scrie oferte, să-i verifice tabele și să-i repare din când în când un script. Deschide meniul și vede două modele, cinci niveluri de efort și o opțiune nouă, „advisor”. Fiecare sună bine. Niciuna nu-i spune cât îl costă pe treaba lui.
Graficele de la lansare sunt reale și sunt impresionante. Ele măsoară însă teste de laborator, alese și rulate de cei care fac modelul. Întrebarea lui Mihai e mai mică și mai grea: pe munca mea de luni, ce se schimbă dacă apăs pe butonul mai scump?
Ce înseamnă efortul în Claude și de ce schimbă costul?
Efortul e cât de mult se gândește modelul înainte și în timpul lucrului. Seamănă cu tâmplarul care măsoară de două ori și taie o dată: la o ușă nouă măsori de trei ori, la o șipcă tai din ochi. Gânditul în plus se plătește în tokeni, unitatea în care se numără textul citit și scris de model.
În Claude Code, Opus 5.5 și Fable 5.2 au cinci niveluri: low, medium, high, xhigh și max. Dacă nu alegi nimic, ambele pornesc pe medium, spune documentația Claude Code. Tot acolo, nivelul high e recomandat pentru reparații de bug-uri într-un cod existent.
Despre max, documentația e directă: „max may show diminishing returns and is prone to overthinking”. Pe românește, poate aduce tot mai puțin pentru fiecare token în plus și tinde să se gândească prea mult, așa că merită testat înainte să-l folosești peste tot. L-am testat pe munca noastră.
Ce face consilierul din Claude Code și cine decide când e chemat?
Consilierul (în engleză „advisor”) e un al doilea model, cel puțin la fel de puternic, pe care Claude îl poate consulta în timpul lucrului. Seamănă cu colegul senior pe care îl suni când te-ai blocat. Diferența: la fiecare telefon, el recitește tot dosarul de la zero.
Asta scrie în pagina oficială a consilierului: e experimental, vede toată conversația și fiecare apel o procesează din nou, fără să refolosească ce a citit data trecută. Claude decide singur când îl cheamă, de obicei înainte să aleagă o abordare, la o eroare care se repetă și înainte să spună că a terminat.
Consilierul cere API-ul Anthropic, Claude Platform on AWS sau Claude Models on Google Cloud, varianta gestionată de Anthropic. Pe ultimele două, consilierul cere Claude Code 2.1.300 sau mai nou, iar Fable 5.2 cere oriunde 2.1.321 sau mai nou, spune aceeași pagină.
Pe Opus 5.5 poți pune drept consilier Opus sau Fable. Pe Fable 5.2, doar Fable 5.2. Dacă vrei un apel anume, i-l ceri în mesaj, de exemplu „consultă consilierul înainte să continui”. O setare care să-l oblige sau să-l limiteze nu există, spune aceeași pagină.
De unde vine ideea: Anthropic a descris-o în primăvară în articolul The advisor strategy, pe modelele de atunci. Cifrele de acolo sunt pe alte modele decât cele de azi, așa că nu le iau drept dovadă pentru Opus 5.5 sau Fable 5.2.
Ce spune Anthropic despre Fable 5.2 vs Opus 5.5?
Fable 5.2 a apărut pe 9 noiembrie 2026. În anunțul Anthropic, pe un test de programare numit FrontierCode 2.0, Fable 5.2 pe high are 45,3%, aproape cât cel mai bun scor al lui Opus 5.5, de 45,5%, la aproximativ jumătate din costul pe sarcină. Pe xhigh, Fable urcă la 49,1%.
Pe alte teste, anunțul dă Fable 5.2 pe medium la nivelul celui mai bun scor Opus 5.5, pentru circa 40% din cost (WANDR, sarcini mari de adunat date). Pe un examen de nivel expert (Humanity’s Last Exam), Fable pe low ajunge scorul maxim al lui Opus sub o zecime din cost.
Recomandarea Anthropic e mai prudentă decât graficele: pornești cu Opus 5.5, pe care îl numesc cel mai puternic model de zi cu zi, și treci la alt model când munca o cere.
Prețul de listă, de pe pagina de prețuri: Opus 5.5 are 4 dolari pe milion de tokeni citiți și 20 pe milion scriși. Fable 5.2 are 8 și 40, adică exact dublu.
Ce spun alții despre costul lui Fable?
Artificial Analysis, o firmă independentă care testează modele, a rulat ambele modele pe toate nivelurile de efort. Pe pagina lor de comparație, la max, pe sarcinile din indicele lor și la prețurile API, Fable 5.2 costă în medie 26,54 dolari pe sarcină, iar Opus 5.5 10,04 dolari. Fable e de 2,64 ori mai scump.
Același tabel arată și partea cealaltă. Pe indicele lor de inteligență, Fable 5.2 pe high are 62 de puncte la 9,08 dolari, peste Opus 5.5 pe max, care are 59 de puncte la 10,04 dolari. Pe scurt: Fable la maxim e scump, iar Fable pe high bate Opus la maxim și costă mai puțin.
Ce am măsurat eu și cum?
Am ales trei sarcini pe care le facem în mod obișnuit. Prima e o reparație de cod: un bug pe care l-am avut chiar noi, într-o verificare care citește arhive și nu vedea a doua arhivă când două erau lipite una de alta. L-am pus la loc într-o copie, iar testul care îl prinde l-am ținut ascuns de model.
A doua e un paragraf de blog în română, cu reguli stricte: lungime, diacritice corecte, fără semne de punctuație pe care nu le folosim și fără o anumită figură de stil care sună a text de AI.
A treia e o întrebare cu o capcană: câte dintre aptitudinile robOS au setat efortul mare. O căutare grăbită găsește 34, fiindcă trei dintre ele pomenesc setarea doar în text. Răspunsul corect e 31.
Fiecare sarcină a rulat pe Opus 5.5 fără consilier, cu consilier Opus și cu consilier Fable, toate pe medium. Apoi pe Opus 5.5 high și max și pe Fable 5.2 low, medium și high, fără consilier. Câte 3 rulări pe fiecare, 72 în total, notate de un program, fără să citesc eu rezultatul înainte.
Costul e cel calculat de Claude Code după prețul de listă, adică cât ar fi costat pe cheie API. Pe un abonament, aceeași muncă se scade din limita planului. Excepția, spune documentația: pe unele planuri, Fable se plătește din credite separate.
Am urmărit și o capcană de măsurare. Fiecare rulare a plătit o parte din încărcarea memoriei rapide a modelului, iar suma a variat mult de la o rulare la alta. O diferență de cost o spun doar dacă rămâne și fără acea încărcare.
Ce a ieșit pe cele trei sarcini?
Toate cele 72 de rulări au trecut verificările programului. Fiecare combinație a trecut, de fiecare dată, testul ascuns de la cod, regulile verificate la paragraf și cifrele de la întrebare. Pe sarcinile astea, efortul în plus și consilierul n-au schimbat nota. Diferențele pe care le compar mai jos sunt la timp și la bani.
Asta e și limita măsurătorii. Sarcinile au ieșit la îndemâna tuturor combinațiilor, deci nu arată unde un efort mai mare chiar ajută. Arată timpul și costul pe trei sarcini pe care toate combinațiile le-au trecut.
Și nota are limitele ei. La cod, programul a rulat testul ascuns. La întrebare, a comparat cifrele. La paragraf a verificat lungimea, semnele interzise, lipsa sedilei, cel puțin 10 diacritice și câteva formulări fixe ale figurii de stil.
N-a verificat fiecare cuvânt în parte și nici cât de bine sună paragraful. La cod, comentariile din fișier pomeneau arhivele lipite, un indiciu pe care l-au avut toate combinațiile, la fel.
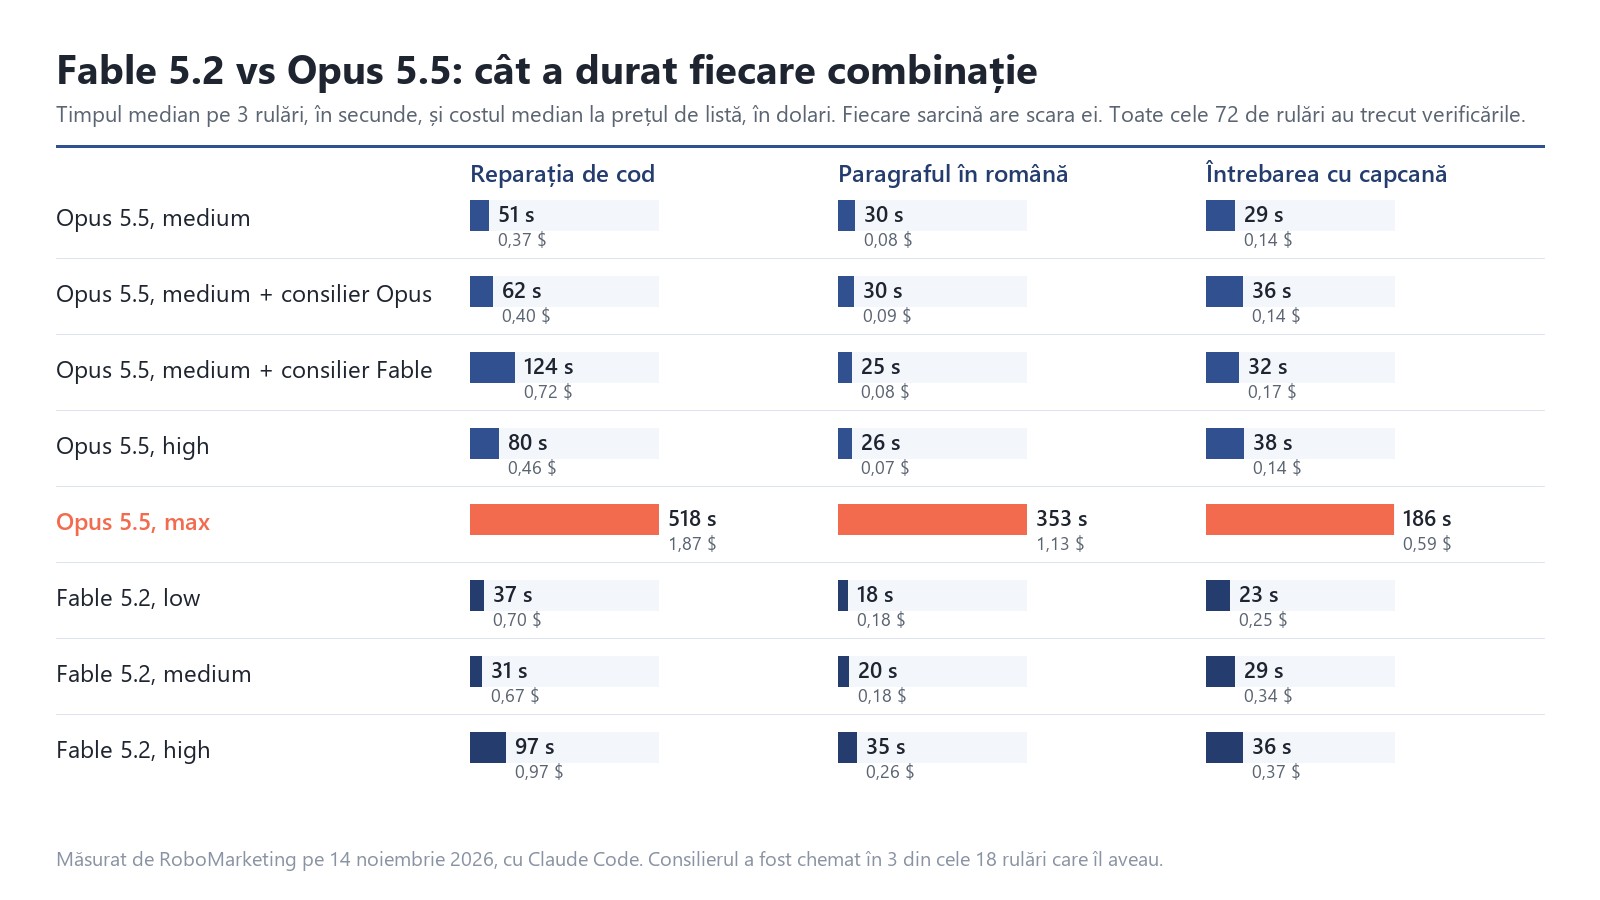
Pe cod și pe paragraf, Opus 5.5 pe max a fost cel mai lent: fiecare rulare pe max a durat mai mult decât orice altă rulare.
Pe reparația de cod a stat 518 secunde, față de 51 pe medium, de vreo zece ori mai mult. Pe paragraf a stat 353 de secunde față de 30, iar pe întrebare 186 față de 29. Cifrele sunt mediane pe trei rulări, iar față de Opus pe medium diferența s-a repetat la fiecare rulare, pe toate trei sarcinile.
Pe max, Opus a scris, la mediană, de 8 până la 25 de ori mai mulți tokeni decât pe medium și a trecut aceleași verificări. Între medium și high, la Opus, n-am găsit o diferență de timp care să se repete la fiecare rulare.
Pe paragraf, Fable 5.2 pe low a fost cel mai rapid, cu 18 secunde. Pe medium a avut 20. Amândouă au fost mai rapide decât Opus pe medium, cu 30 de secunde, la fiecare rulare.
Pe întrebare, Fable pe low a fost și el mai rapid decât Opus pe medium la fiecare rulare (23 de secunde față de 29). Între Fable pe medium și Opus pe medium, pe cod și pe întrebare, diferența de timp s-a schimbat de la o rulare la alta, așa că n-o trec drept rezultat.
La cost, max iese tot cel mai scump. Opus pe max a costat de 4 până la 14 ori mai mult decât pe medium: 1,87 dolari față de 0,37 pe cod, 1,13 față de 0,08 pe paragraf și 0,59 față de 0,14 pe întrebare. Diferența rămâne și fără încărcarea inițială a memoriei rapide.
Fable 5.2 pe medium a costat de circa două ori cât Opus 5.5 pe medium, pe paragraf (0,18 față de 0,08 dolari) și pe întrebare (0,34 față de 0,14). E cam dublu sau puțin peste, în linie cu prețul de listă. Pe cod, diferența a depins de memoria rapidă și nu s-a repetat pe costul fără încărcarea ei.
Toată seria, cu cele 72 de rulări, a costat 31,59 dolari la prețul de listă.
Cât de des a chemat Claude consilierul și ce a schimbat?
Consilierul a fost disponibil în 18 rulări: 9 cu consilier Opus și 9 cu consilier Fable. Claude l-a chemat de 3 ori. De două ori a chemat consilierul Fable, ambele pe reparația de cod, și o dată consilierul Opus, pe întrebare. Pe paragraf nu l-a chemat deloc.
Fiecare apel s-a văzut în cost, calculat la prețul de listă. Cele două apeluri la Fable au costat 0,51 și 0,52 dolari, adică 70% și 55% din costul rulării. Rulările acelea au durat 127 și 124 de secunde.
Pe aceeași setare, Opus 5.5 medium, cu consilierul oprit, mediana a fost 51 de secunde, iar cea mai lungă rulare 104. Apelul la Opus a costat 0,16 dolari, aproape jumătate din rulare.
Rulările au trecut verificările și cu apel, și fără apel. Costul apelurilor l-am măsurat direct.
Cele 3 rulări cu apel au durat mai mult decât orice rulare pe Opus 5.5 medium cu consilierul oprit, pe aceeași sarcină, dar n-am cum să știu cât ar fi durat aceleași rulări fără apel. Ce i-a spus consilierul lui Claude nu pot arăta: în modul în care am rulat, răspunsul lui vine criptat.
Documentația spune același lucru din alt unghi: consilierul se potrivește la sarcini lungi, cu mulți pași, și aduce mai puțin pe sarcinile scurte, unde e puțin de planificat. Sarcinile noastre au fost din a doua categorie.
Ce alegi luni dimineață?
Pentru munca de zi cu zi, cu sarcini clare, rămâi pe Opus 5.5 medium, setarea implicită. Pe toate trei sarcinile a trecut verificările, printre cele mai ieftine combinații.
Max îl păstrezi pentru problemele grele pe care le lași să ruleze fără tine, cum spune și documentația. Pe munca noastră a durat de 6 până la 12 ori mai mult și a costat de 4 până la 14 ori mai mult, și a trecut aceleași verificări.
Fable 5.2 merită pe munca grea, unde testele Anthropic și Artificial Analysis îi dau scoruri mai mari, sau când un text scurt trebuie să iasă repede. Pe paragraful nostru, Fable pe low și pe medium a fost mai rapid decât Opus pe medium la fiecare rulare, iar pe medium a costat cam dublu.
Consilierul îl pornești pe sarcini lungi, cu multe decizii. Pe sarcinile noastre scurte, Claude l-a chemat rar, iar fiecare apel a costat între aproape jumătate și 70% din rulare.
Și un sfat pe care l-am urmat chiar noi: înainte să schimbi setarea pentru toată echipa, dă aceeași sarcină de câteva ori pe două setări și compară timpul și costul.
Unde intră robOS?
Lucrez zilnic cu robOS, sistemul nostru peste Claude Code. Măsurătorile de aici le-am făcut cu el: a pregătit copiile, a pornit rulările și a notat fiecare rezultat cu un program, ca cifrele să nu depindă de impresia mea. Detalii despre robOS găsești pe robos.vip.
Dacă vrei să vezi și cât consumă Claude Code în general, am scris un ghid al consumului în Claude Code. Despre cum își verifică Anthropic codul scris de AI am scris aici.
Modelele și recomandările se schimbă în timp, iar odată cu ele se schimbă și ce merită să alegi. Când refac măsurătorile pe un model nou, scriu în newsletter ce s-a schimbat și ce înseamnă pentru costurile tale. Abonează-te ca să afli înainte să plătești degeaba:
Întrebări frecvente
Ce efort folosește Claude Code dacă nu aleg nimic?
Medium, atât pe Opus 5.5, cât și pe Fable 5.2. Îl schimbi cu comanda /effort sau din alegerea modelului, cu săgețile stânga și dreapta. Nivelul max ales așa se aplică doar sesiunii curente.
Consilierul costă în plus?
Da. Fiecare apel citește din nou toată conversația, la prețul modelului consilier. În măsurătorile noastre, un apel la consilierul Fable a costat în jur de jumătate de dolar, peste jumătate din costul rulării. Pe abonament, consumul lui intră în limitele planului, iar pe unele planuri consilierul Fable se plătește din credite, spune documentația.
Merită Fable 5.2 pentru munca de zi cu zi?
Pe sarcinile noastre, Fable 5.2 a trecut aceleași verificări ca Opus 5.5. Pe medium a costat cam dublu față de Opus pe medium, pe paragraf și pe întrebare. Pe high, la paragraf, a costat și mai mult. Pentru munca obișnuită, Anthropic recomandă să pornești cu Opus 5.5. Fable îl alegi când munca o cere.
Pot să-l oblig pe Claude să cheme consilierul?
Poți să-i ceri în mesaj, de exemplu „consultă consilierul înainte să continui”. O setare care să forțeze sau să limiteze apelurile nu există.
Cum văd cât a consumat o sarcină?
Comanda /usage arată consumul sesiunii, iar documentația spune că include și consumul consilierului. Mai multe despre consum găsești în ghidul consumului.