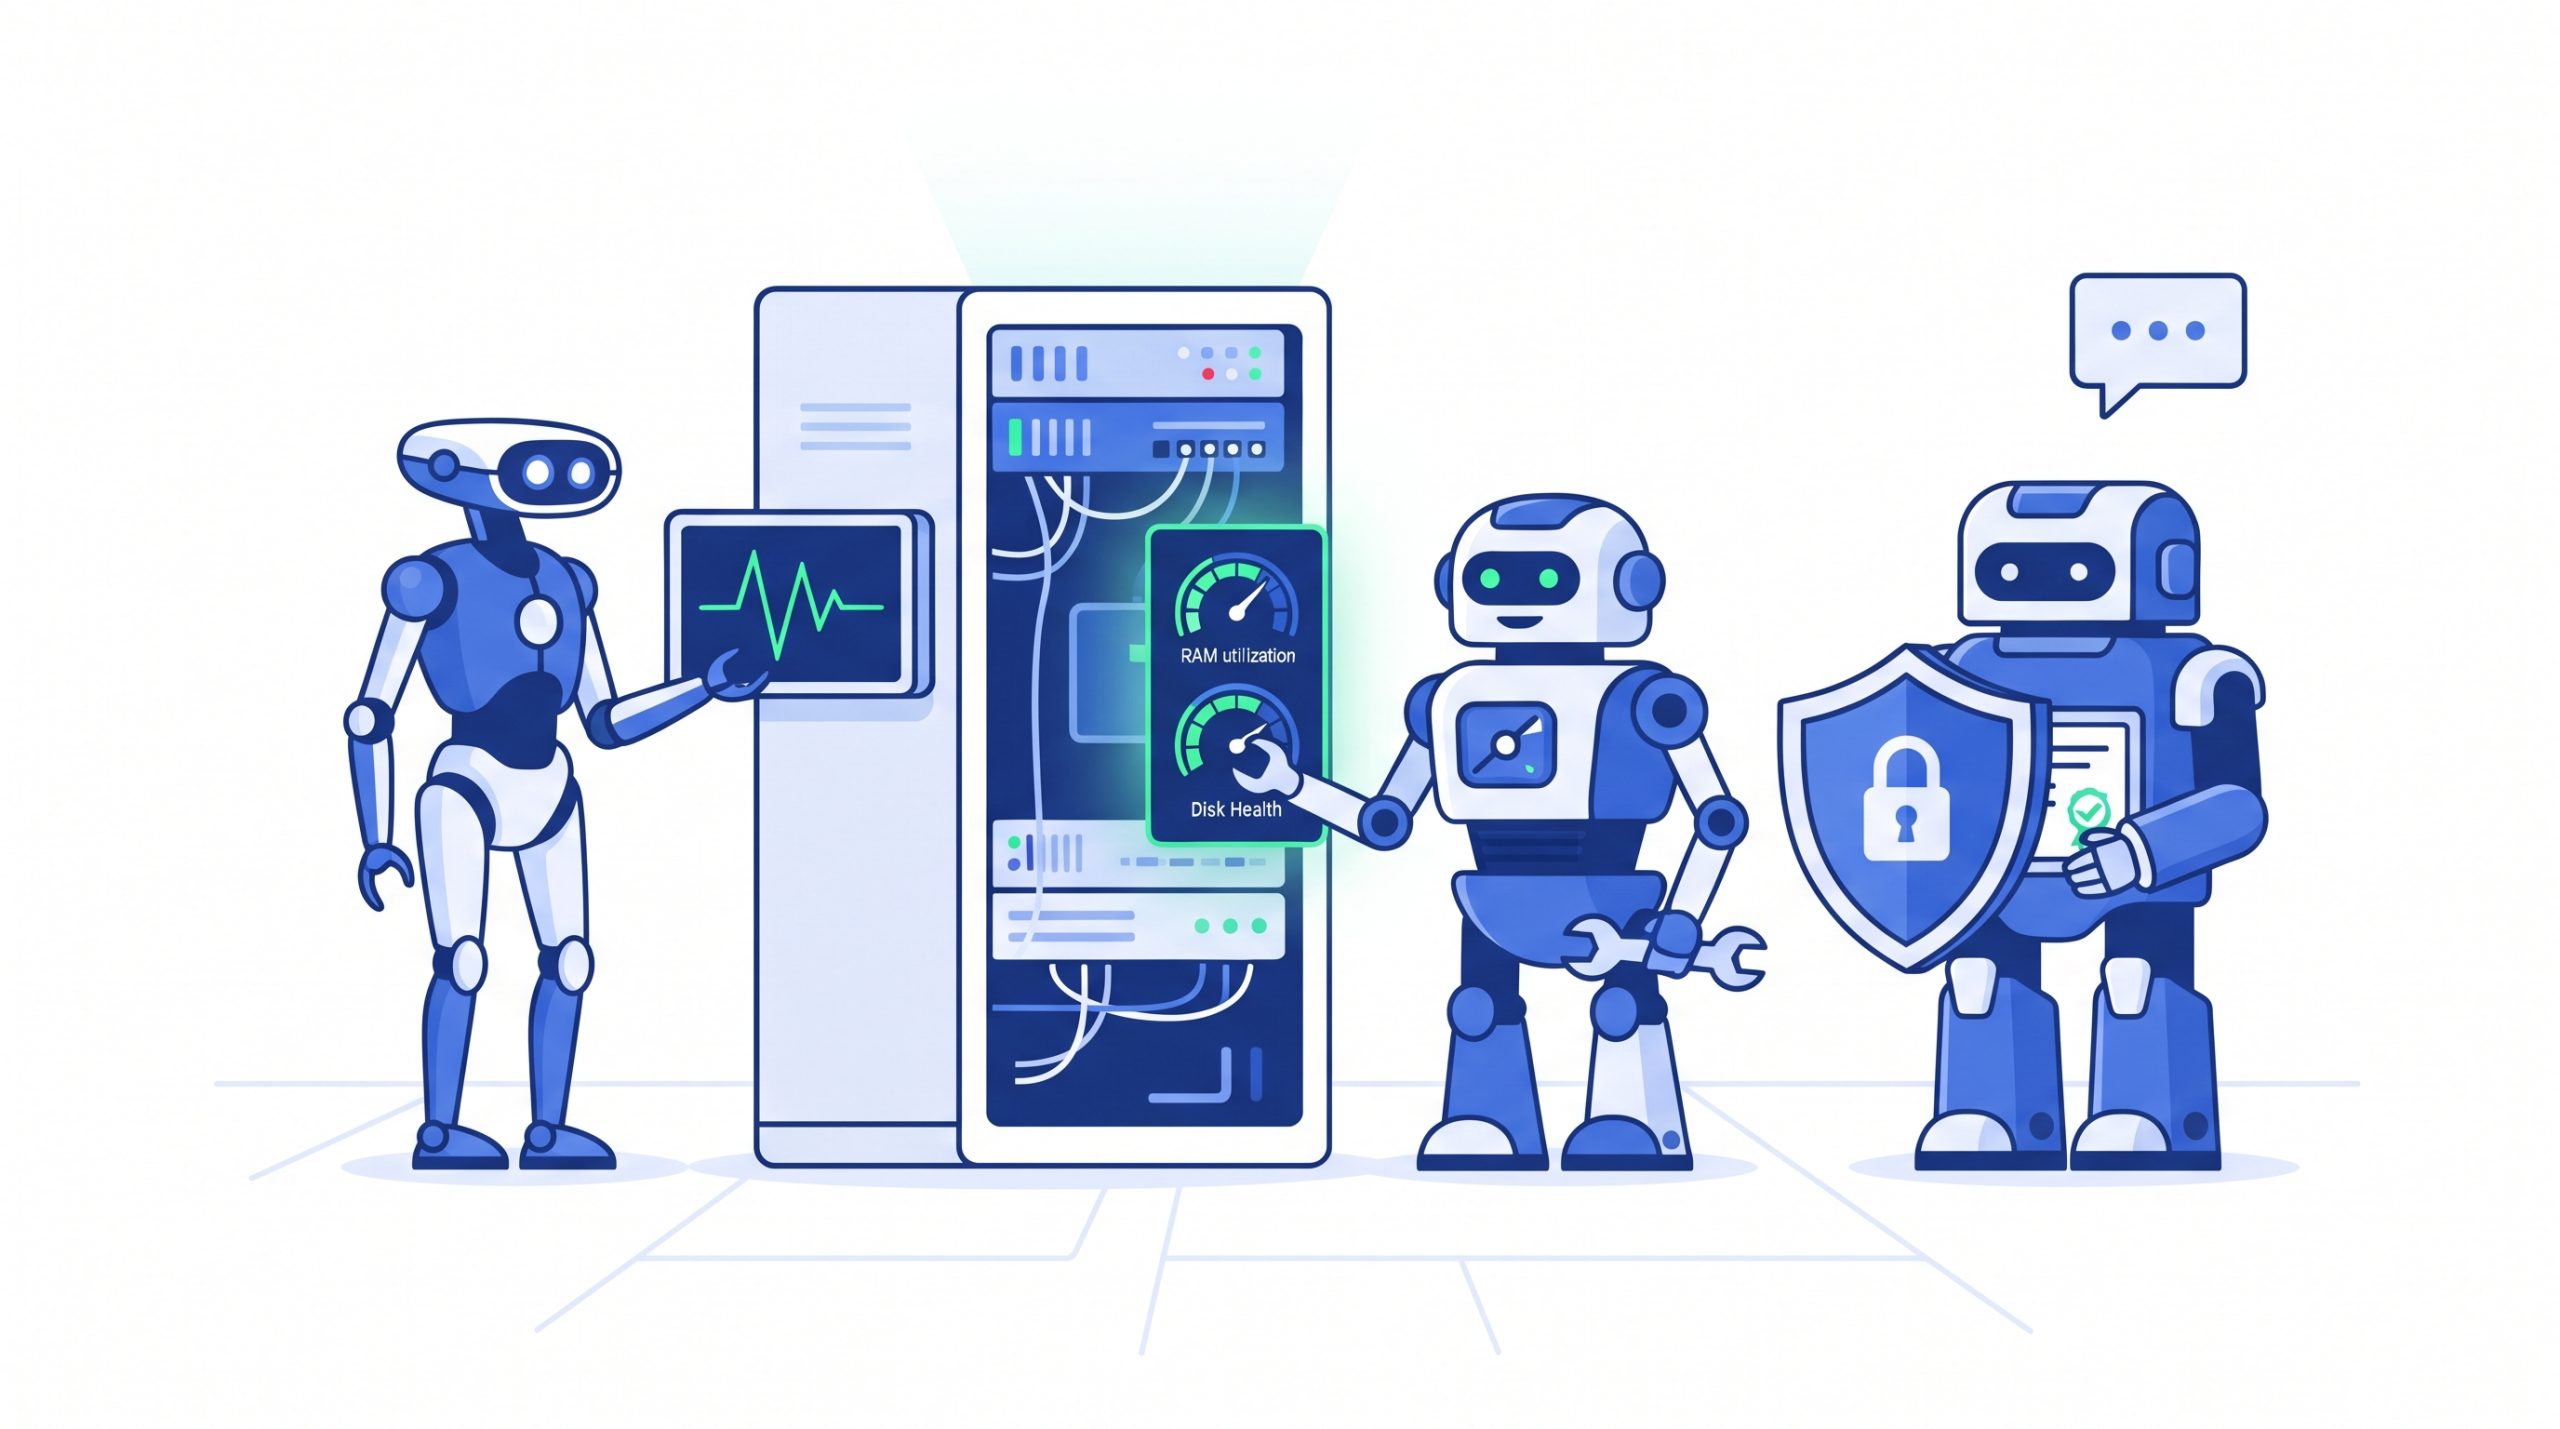
Agenți AI monitorizare server, în varianta noastră, înseamnă trei programe separate care verifică singure infrastructura și scriu pe Slack doar când găsesc o problemă. Unul urmărește dacă site-urile răspund, unul face mentenanța zilnică, iar al treilea se ocupă de securitate și de certificatele SSL.
Le-am construit pentru propria infrastructură, cu zeci de site-uri și aplicații, după ce verificările manuale ale unei persoane dedicate nu mai țineau pasul. Totul a fost operațional în mai puțin de două săptămâni.
În retrospectiva de mai jos afli de ce am ales trei agenți în loc de unul, cum funcționează regula „tace când totul e OK”, ce prag de alertă folosim și ce am corectat după primele luni.
De ce trei agenți separați și nu un singur tool
Am separat monitorizarea în trei agenți pentru că fiecare tip de verificare are alt ritm, altă logică și alte reguli de escaladare. Disponibilitatea se verifică la două ore, mentenanța o dată pe zi, auditul de securitate tot zilnic, dar cu alte praguri. Un singur tool ar fi amestecat toate aceste ritmuri.
În plus, agenții sunt independenți, așa că dacă unul cade, ceilalți doi lucrează mai departe. Un tool monolitic are un singur punct de eșec: o eroare în modulul de securitate poate opri și verificarea de uptime.
Ce face fiecare dintre cei trei agenți
Fiecare agent are o singură treabă și un program fix de rulare. Împărțirea de mai jos e cea din producție, descrisă și în studiul de caz despre monitorizarea serverelor cu trei agenți AI, unde găsești și stiva tehnică completă.
- SRE Monitor verifică disponibilitatea site-urilor la fiecare 2 ore, între 06:00 și 22:00, și scrie pe Slack doar când un site nu răspunde.
- SysAdmin face mentenanța zilnică: curăță sesiunile vechi, urmărește memoria RAM și swap-ul, verifică spațiul pe disc și repornește preventiv serviciile o dată pe săptămână.
- SecOps rulează un audit de securitate în fiecare zi și te anunță când un certificat SSL mai are sub 14 zile până la expirare.
Pragul de 14 zile pentru SSL va conta tot mai mult. Prin votul SC-081 al CA/Browser Forum, durata maximă a certificatelor a scăzut la 200 de zile din martie 2026, urmează 100 de zile din 2027 și 47 de zile din 2029. Mai multe reînnoiri înseamnă mai multe ocazii de a rata una.
Certificatele gratuite Let’s Encrypt sunt valabile 90 de zile. Reînnoirea automată merge de obicei, iar SecOps există pentru dățile când nu merge.
Regula „tace când totul e OK” și pragul de trei verificări
Agenții nu trimit nimic dacă verificarea iese bine. Un mesaj pe Slack înseamnă, de fiecare dată, că există ceva de făcut. Ca să nu alertăm la o sughițare de rețea, SRE Monitor reverifică de două ori, la 5 minute distanță, și trimite alerta doar dacă problema persistă la 3 verificări consecutive.
Un canal plin de mesaje „totul e în regulă” ajunge ignorat în câteva zile, iar mesajul important se pierde printre celelalte. Principiul vine din practica echipelor de operare: în cartea Google despre Site Reliability Engineering, regula de bază e că fiecare alertă trebuie să ceară o acțiune.
Cele 3 verificări la 5 minute înseamnă că un site căzut ajunge la noi după aproximativ 10 minute de la prima verificare eșuată. Am acceptat această întârziere în schimbul unui canal fără alarme false. În producție, sistemul nu a trimis alerte false.
Escaladarea pe severitate: mesaj în canal sau notificare personală
Nu toate problemele au aceeași urgență, așa că agenții au două niveluri de escaladare. Problemele obișnuite ajung în canalul Slack dedicat, cu serviciul afectat, problema și severitatea. Cele critice, cum ar fi un server căzut, un disc plin sau un certificat care expiră, vin și ca notificare personală.
Împărțirea seamănă cu nivelurile de severitate pe care le folosesc multe echipe de incidente, descrise de exemplu în ghidul Atlassian despre nivelurile de severitate. Pentru o echipă mică, două niveluri ajung.
Fiecare mesaj spune ce s-a verificat și ce a ieșit, ca persoana care îl primește la 21:00 să decidă din telefon dacă intervine acum sau a doua zi.
Cum am construit agenți AI monitorizare server în sub două săptămâni
Am construit agenții unul câte unul, iar pe următorul l-am început abia după ce primul a mers stabil. SRE Monitor a durat 2-3 zile, SysAdmin încă 2-3 zile, iar SecOps 3-4 zile. Fiecare a fost testat separat înainte să trecem mai departe.
Orchestrarea rulează în n8n, unde fiecare agent pornește de la propriul declanșator programat (Schedule Trigger). Datele despre disc, memorie și servicii vin din panoul de administrare BT Panel, iar certificatele le verificăm cu Certbot și cu verificatoare SSL. Rapoartele și alertele ajung pe Slack.
Ce nu a mers și ce am schimbat
Regula tăcerii are un punct slab: un agent care nu mai rulează tace exact ca unul care nu are nimic de raportat. Am învățat asta pe 28 iulie 2026, când o actualizare de rutină a șters 16 din 17 sarcini programate, printre ele și agenții de monitorizare. Am observat abia după aproximativ cinci ore.
Am povestit incidentul pe larg în articolul despre monitorizarea automatizărilor și cum am pierdut 16 sarcini din 17. Pentru cei trei agenți, lecția a fost clară: fiecare are acum un watchdog separat care verifică dacă a rulat la ora programată. Dacă un agent nu raportează la timp, watchdog-ul trimite alertă pe Slack.
A doua corecție ține de limitele automatizării. SysAdmin poate reporni servicii și face curățenie singur, dar la vulnerabilități și configurări agenții doar detectează și raportează. Decizia rămâne la un om. Un exemplu bun de ce e nevoie de om e incidentul cu minerul crypto ascuns pe server.
Miza nu e mică. Conform raportului IBM Cost of a Data Breach 2024, un incident de securitate a costat în medie 4,88 milioane de dolari. O firmă mică nu ajunge la cifra asta, dar proporțiile rămân aceleași: problema prinsă devreme costă mult mai puțin.
Ce rezultat am obținut și ce poți copia
Persoana care făcea verificările manual s-a mutat pe sarcini mai utile. Uptime, SSL, disc, RAM și securitatea sunt monitorizate automat, pe programe diferite, iar problemele apar înainte să le observe clienții. Practic am eliminat o muncă repetitivă pe care cartea Google despre SRE o numește toil și pe care recomandă să o ții sub 50% din timpul echipei.
Dacă administrezi și tu mai multe site-uri, poți începe chiar săptămâna asta:
- Scrie lista verificărilor pe care le faci acum de mână și notează cât de des le faci.
- Grupează-le după ritm: ce verifici la câteva ore, ce verifici zilnic, ce verifici săptămânal. Fiecare grup poate deveni un agent.
- Pornește cu disponibilitatea și cu pragul de 3 verificări eșuate, ca să ai liniște în canal din prima zi.
- Adaugă de la început un watchdog care confirmă că agenții au rulat.
Dacă vrei să construim împreună un sistem de agenți AI monitorizare server pentru infrastructura ta, citește ce includem în serviciul de automatizare procese business. Pentru un exemplu de agenți AI care produc conținut, nu verificări, vezi studiul de caz în care am construit un blog autonom AI în 58 de ore.
Scriu despre sistemele noastre interne după ce rulează de câteva luni, cu cifrele și cu greșelile lângă. Dacă vrei să primești pe email următoarele retrospective de acest fel, abonează-te la newsletter:
Întrebări frecvente despre agenți AI pentru monitorizare server
Ce sunt agenții AI pentru monitorizare server?
Un sistem de agenți AI monitorizare server e format din programe care rulează singure, după un program fix, și verifică disponibilitatea site-urilor, resursele serverului și securitatea. La noi sunt trei agenți separați, SRE Monitor, SysAdmin și SecOps, care scriu pe Slack doar când găsesc o problemă reală.
Cât durează implementarea a trei agenți AI de monitorizare?
La noi a durat sub două săptămâni: SRE Monitor 2-3 zile, SysAdmin 2-3 zile și SecOps 3-4 zile. Fiecare agent a fost testat separat înainte de următorul, iar calibrarea pragurilor de alertă a continuat după lansare.
Cum eviți alertele false la monitorizarea serverelor?
Nu trimiți alerta la prima verificare eșuată. SRE Monitor reverifică de două ori, la 5 minute distanță, și alertează doar dacă problema persistă la 3 verificări consecutive. Așa scapi de alarmele cauzate de o problemă de rețea de câteva secunde.
Ce se întâmplă dacă unul dintre agenți nu mai rulează?
Fiecare agent are un watchdog separat care verifică dacă a rulat la ora programată. Dacă agentul nu raportează la timp, watchdog-ul trimite alertă pe Slack. Agenții sunt independenți, așa că oprirea unuia nu îi afectează pe ceilalți doi.
Agenții AI de monitorizare repară singuri problemele?
Doar pe cele standard. SysAdmin poate reporni servicii, curăța fișiere temporare și elibera resurse. La vulnerabilități și configurări, agenții detectează și raportează, iar decizia de intervenție o ia un om.
Funcționează monitorizarea cu agenți AI și pe serverul meu?
Da, dacă există acces SSH sau API la server. Agenții pot verifica orice server care expune metrici de bază, cum ar fi uptime, disc și RAM, și care permite rularea scripturilor de verificare.