
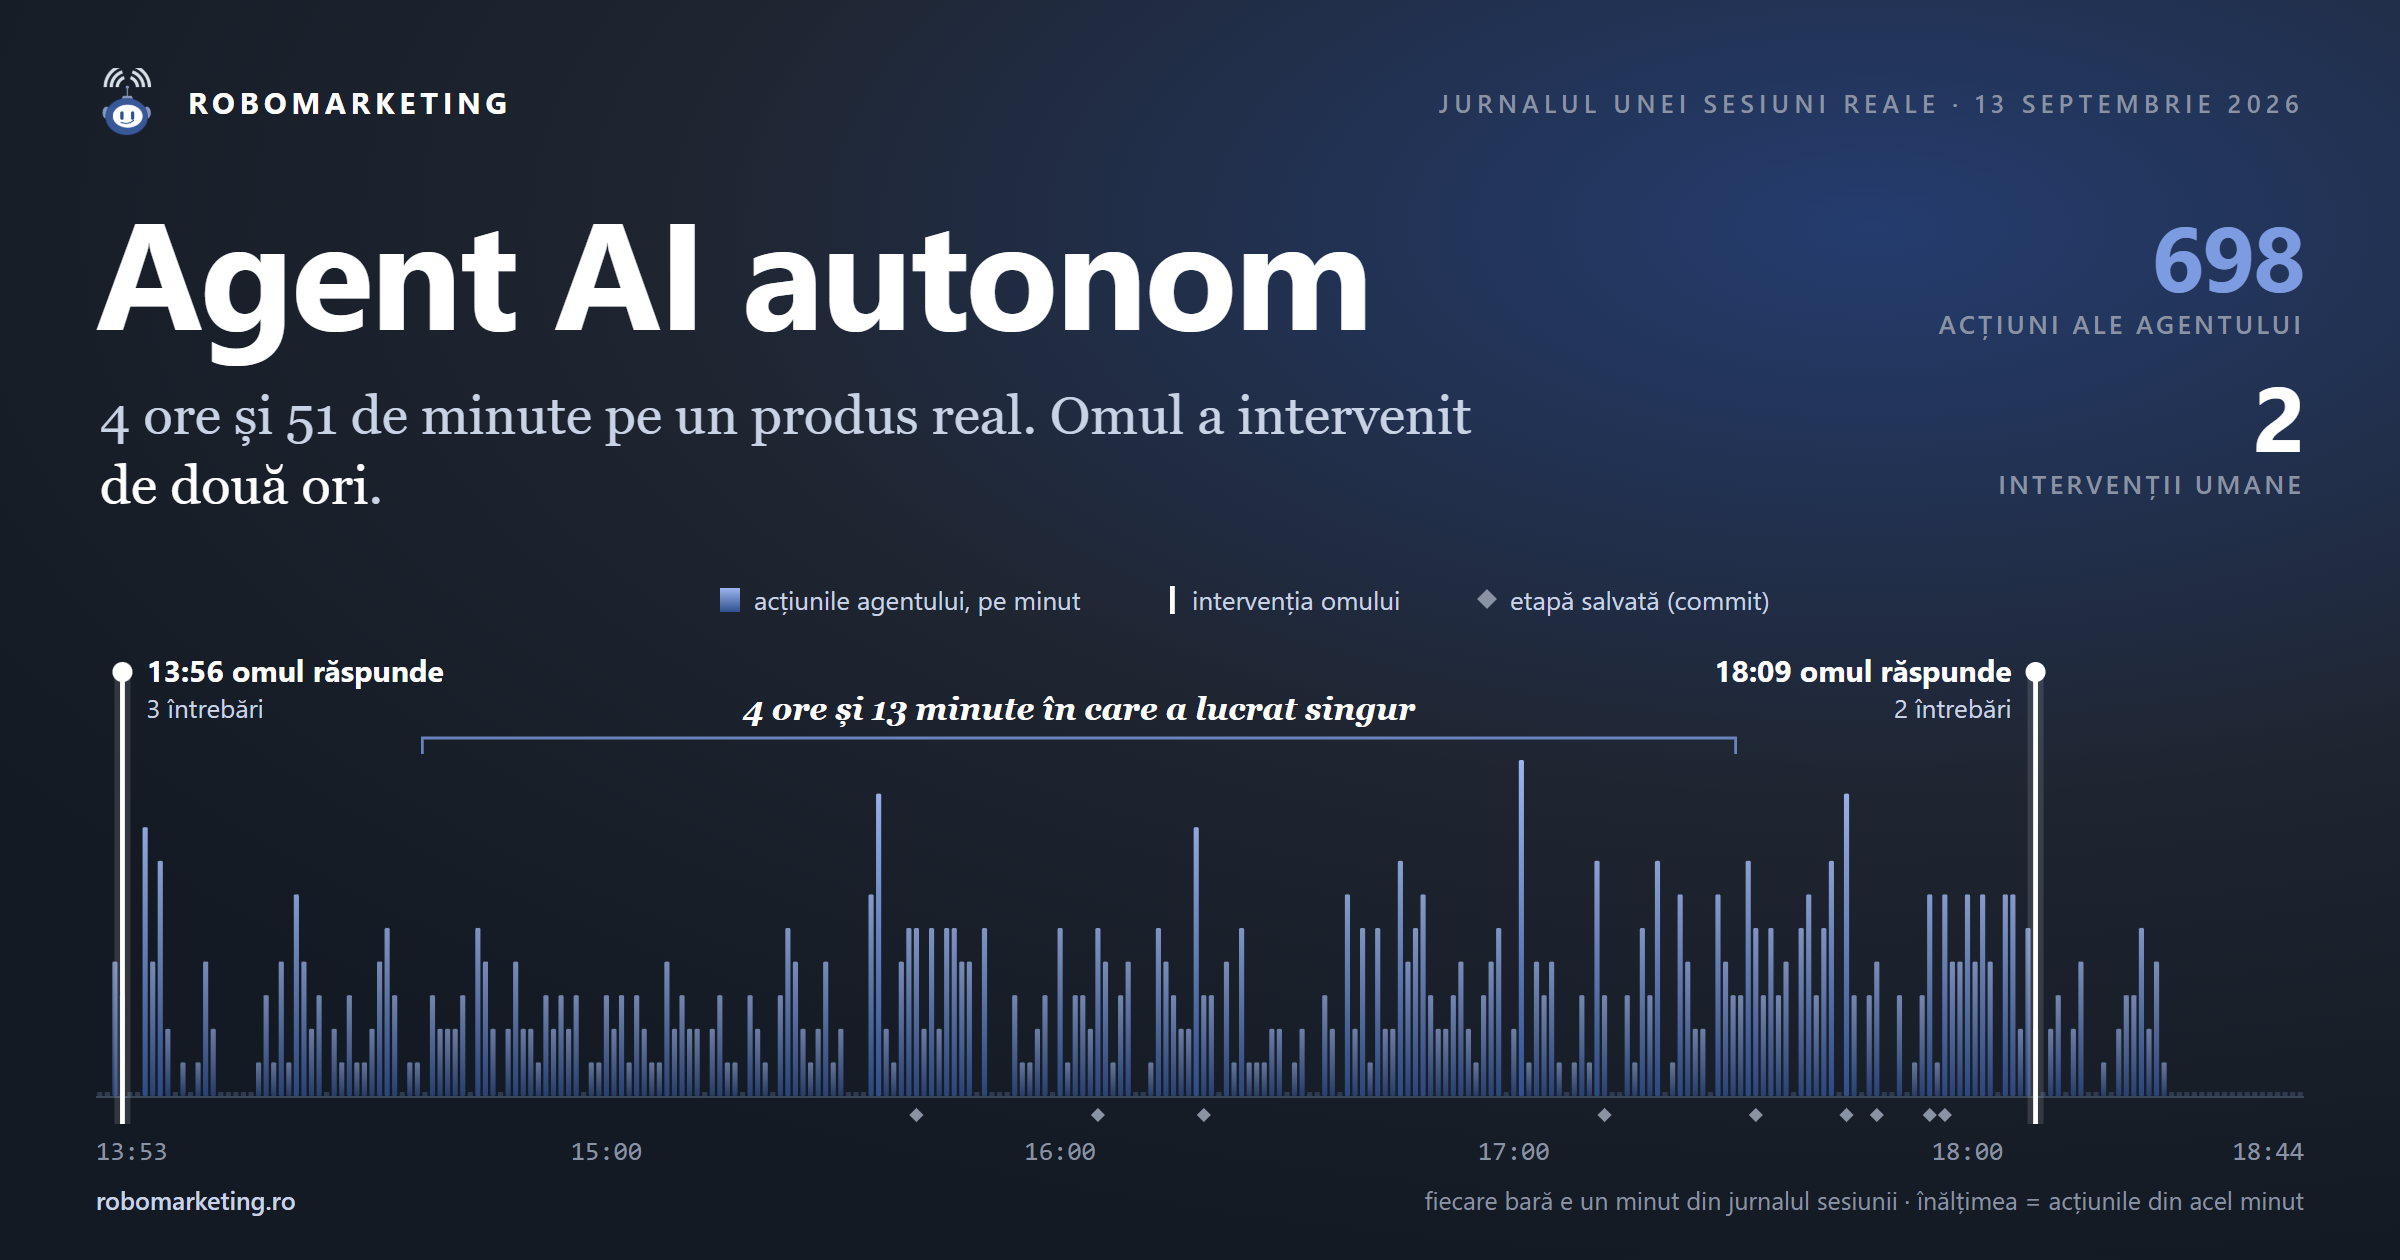
Pe scurt: un agent AI autonom construit pe robOS a lucrat 4 ore și 51 de minute pe un produs real, cu 698 de acțiuni, nouă commituri și două momente în care a cerut o decizie omului. Articolul arată ce a făcut și, mai ales, ce l-a oprit să facă greșeli: planul scris în fișiere, lucrul pe copii, testele verificate prin stricare intenționată, un al doilea AI (Codex) care caută defecte și oprirea înainte de orice operație care nu se mai poate lua înapoi.
Pe 13 septembrie, la 13:53, i-am trimis asistentului meu AI un mesaj scris în grabă. Următorul mesaj pe care i l-am scris a fost la 18:44. Între ele, sistemul a lucrat singur pe un produs nou, pe care urmează să-l livrez primilor cumpărători: a scris cod, l-a testat pe un server, a pus un alt AI să-i caute greșelile, le-a reparat și a făcut nouă salvări oficiale ale muncii terminate. Eu am intervenit de două ori, ca să răspund la întrebări pe care mi le-a pus el.
Articolul e pentru cine se gândește să lase un agent AI autonom să lucreze singur ore întregi și se întreabă, pe bună dreptate, ce poate strica. Nu trebuie să fii programator ca să-l citești. Fiecare termen tehnic are explicația chiar lângă el.
Are două părți. În prima îți arăt ce a făcut agentul AI autonom în acea după-amiază, cu orele și cifrele scoase din jurnalul sesiunii și din istoricul proiectului. În a doua îți explic cum am ajuns să-l las să lucreze așa, ce îl oprește să facă prostii și unde a greșit totuși.
Ce e robOS și la ce lucra în ziua aceea
robOS e sistemul de lucru pe care îl construiesc din 4 mai 2026 peste Claude Code. Claude Code e asistentul de programare făcut de Anthropic: un AI care, pe lângă răspunsurile din chat, poate citi fișiere, poate rula comenzi și poate modifica cod pe calculatorul tău. În spatele lui lucrează un model AI, adică programul antrenat care înțelege textul și decide ce urmează, în cazul ăsta Claude.
Singur, un asemenea asistent seamănă cu un angajat foarte capabil, venit ieri în firmă. Știe multe, dar nu știe nimic despre tine, uită tot la sfârșitul zilei și nu are proceduri. robOS îi dă ce îi lipsește: o memorie care rămâne de la o zi la alta, reguli de lucru, unelte specializate și mecanisme care îl opresc când e pe cale să greșească.
Un agent AI, ca să lămurim termenul, e un AI căruia îi dai o sarcină și care o duce singur la capăt, pas cu pas, folosind unelte. Diferența față de un chat obișnuit e aceeași ca între un om căruia îi pui o întrebare și un om căruia îi dai o sarcină de făcut până vineri. Un agent AI autonom merge un pas mai departe: lucrează ore întregi fără să aștepte o instrucțiune pentru fiecare pas.
În după-amiaza aceea, robOS lucra la un addon, denumit de mine robOS studIO. Studio e o fabrică de conținut: un grup de agenți AI, fiecare cu specialitatea lui (cercetare, articole, postări, SEO, adică optimizare pentru căutările din Google, plus scenarii pentru video), care rulează pe un server și primesc comenzi pe Telegram. Serverul e un calculator închiriat, care stă pornit tot timpul într-un centru de date. Pe Telegram vorbești cu un bot, un cont automat care transmite cererile tale agenților. Scrii pe telefon ce material vrei, agenții se apucă de treabă și îți trimit rezultatul înapoi în conversație.
Sarcina avea mai multe bucăți: comenzi noi în Telegram, o cale simplă de actualizare, accesul cumpărătorului la serverul lui și protecții pentru situațiile în care ceva se oprește la jumătate. Planul pe etape îl propusesem lui robOS, într-o analiză făcută mai devreme în aceeași zi.
Mesajul de la 13:53
I-am scris așa:
fa tot din plan. rezolva fiecare problema ridicata. acolo unde ai indoieli, intreaba inainte. vei face verificari de cod si bug-free intermediare. foloseste pentru asta si codex
Mesajul nu are liste, nu are criterii de acceptare și nu spune ce fișiere să atingă. Spune trei lucruri: indeplineste planul, întreabă când ai îndoieli și verifică pe parcurs, inclusiv cu Codex. Restul trebuia să știe sistemul.
Codex e asistentul de programare al OpenAI, adică al altei firme decât cea care face Claude. Revin la el mai jos, fiindcă a avut un rol important în povestea asta.
Ce a făcut singur între 13:53 și 18:44
Munca terminată a fost salvată prin commituri. Un commit e o salvare oficială în istoricul proiectului, cu o descriere a ce s-a schimbat. Seamănă cu o versiune semnată a unui contract: știi exact ce s-a modificat și când, și te poți întoarce oricând la versiunea de dinainte. În după-amiaza aceea, niciun commit nu s-a făcut înainte ca schimbarea lui să treacă verificările.
Au fost nouă commituri: șapte etape din plan (una dintre ele salvată în două bucăți) și o reparație găsită pe drum. Cu ora lor din istoricul proiectului:
- 15:41: manualul de utilizare al Studio a intrat în sistem, într-o formă pe care asistentul o poate consulta oricând, cu teste care verifică că manualul nu rămâne în urma codului.
- 16:05: dreptul de a descărca Studio se verifică strict, pe toate căile prin care poate fi acordat, iar la lansarea unei versiuni noi pachetul Studio se urcă automat.
- 16:19: comenzi noi în Telegram. /ajutor explică ce poți cere, /stare arată ce lucrează acum, /opreste oprește o lucrare pornită. Iar la un „mulțumesc” Studio răspunde fără să mai pornească un AI.
- 17:12: parola botului de Telegram nu mai apare în lista de programe care rulează pe server (listă pe care o poate citi orice alt program de acolo). În plus, lucrările întrerupte de o repornire a serverului sunt anunțate în conversație și pot fi reluate cu un simplu „reia”.
- 17:32: reparația unui defect ascuns în verificările automate de text. Îl povestesc mai jos, fiindcă e una dintre cele mai interesante probleme ale zilei.
- 17:44: Studio înțelege mesajele în contextul conversației. Când nu e sigur ce vrei, te întreabă și îți dă variante.
- 17:48: Studio se actualizează cu o singură comandă. Comanda verifică versiunea nouă, iar dacă ceva nu merge încearcă să revină singură la cea veche și spune clar dacă revenirea nu a reușit complet.
- 17:55: cumpărătorul primește acces la serverul lui, din terminal (fereastra în care scrii comenzi text) sau din VS Code, un editor de cod foarte folosit.
- 17:57: manualul îi arată cumpărătorului cum să verifice arhiva de instalare înainte s-o deschidă, cu o amprentă publicată separat. Amprenta e un șir de caractere calculat din conținutul fișierului: dacă se schimbă un singur caracter din fișier, amprenta se schimbă complet. E ca atunci când compari seria de pe factură cu seria de pe produs.
Primul commit a venit abia la 15:41, la aproape două ore de la pornire. Sistemul lucrase tot timpul: primele ore s-au dus pe construcția și verificarea mai multor etape deodată, iar salvarea oficială vine doar după ultima verificare. Apoi, între 17:12 și 17:57, au plecat șase commituri, fiindcă etapele pregătite în paralel au terminat verificările aproape în același timp.
Cât a lucrat agentul AI autonom, în cifre
Am numărat pașii din jurnalul sesiunii, strict între mesajul de la 13:53 și cel de la 18:44. Un pas înseamnă o acțiune concretă: o comandă rulată, un fișier citit, o modificare de cod. Un om care face aceeași muncă face și el astfel de pași. Diferența e că aici fiecare pas rămâne înregistrat.
- 698 de acțiuni în total.
- 500 de comenzi rulate.
- 99 de modificări în fișiere existente și 89 de scrieri de fișiere, noi sau rescrise complet.
- 47 de comenzi care au pornit Codex, câteva dintre ele reluate după ce nu au mers din prima.
Mai mult decât volumul m-a interesat altceva. La începutul după-amiezii, suita de teste a lui Studio avea 198 de teste. Seara, pe copia de lucru care conținea și etapele încă nesalvate, avea 385. Pe lângă ea au apărut două seturi separate, cu 35 de scenarii pentru actualizare și 25 pentru acces.
Un test e o verificare automată: un mic program care pune sistemul într-o situație anume și verifică dacă se comportă cum trebuie. De exemplu, trimite comanda /opreste pentru o lucrare care nu există și verifică dacă primești un mesaj clar, fără ca serviciul să cadă. Suita de teste e lista lor completă, rulată de fiecare dată, ca lista de verificare a unui pilot înainte de decolare. Aproape 190 de teste noi înseamnă aproape 190 de situații noi verificate automat la fiecare rulare. Și, cum vei vedea mai jos, testele pot avea și ele greșeli.
Unde am intervenit eu
La 13:56, la trei minute după pornire, m-a întrebat trei lucruri, fiecare cu variante și cu o recomandare:
- dacă cumpărătorii primesc acces direct la serverul lor;
- ce model AI citește și înțelege mesajele primite pe Telegram;
- cum se actualizează Studio: automat sau printr-o comandă dată de om.
A întrebat imediat, fiindcă răspunsurile schimbau planul. La a doua întrebare am ales altceva decât recomandarea lui.
La 18:09 au venit două întrebări apărute pe drum, după un audit despre care îți povestesc mai jos. Una era despre cât de strict separăm agenții de restul serverului, cealaltă despre cât timp păstrăm istoria conversațiilor.
Nu am fost întrebat nimic din ce era tehnic și avea un răspuns corect: cum se numește o funcție, cum se construiește un test, în ce ordine merg etapele, ce reparație se potrivește unei probleme. Pe astea le-a decis singur și le-a notat, ca să le pot verifica după.
În sistem e scrisă o regulă pentru întrebări: faci întâi tot ce poți face singur, apoi pui întrebarea și te oprești din ce depinde de ea. Omul e chemat la decizie, iar munca pe care nu o schimbă răspunsul lui merge mai departe.
De unde vine viteza
Poate te gândești că viteza vine din faptul că un agent AI autonom scrie cod mai repede decât un om. Scrie mai repede, dar după ce am citit jurnalul, impresia mea e că diferența mare vine din altă parte.
O rulare completă a testelor pe server durează câteva minute. O verificare făcută de Codex durează și ea minute. Un om ar aștepta. Sistemul pornea verificarea în fundal, adică o lăsa să ruleze separat, și între timp scria etapa următoare. Când verificarea se termina, primea un semnal, citea rezultatul și reacționa.
E ca un bucătar care pune supa pe foc și, cât fierbe, taie legumele pentru felul doi. Cu o regulă strictă: o etapă care depinde de alta se aplică numai după ce etapa de dinainte a fost salvată oficial. Sosul se toarnă doar peste o friptură care e gata.
Cum evită un agent AI autonom prostiile: drumul unei schimbări până în produs
Până aici e partea spectaculoasă. Partea care contează răspunde la altă întrebare: de ce am avut încredere să-l las singur aproape cinci ore pe un produs pe care îl vând? Un agent AI autonom e util exact cât sunt de bune limitele din jurul lui.
Pe scurt, o schimbare trece prin mai multe filtre, fiecare construit să prindă alt tip de greșeală, înainte să fie salvată. Le iau pe rând și îți spun și unde filtrele nu au fost aplicate perfect.
1. Planul și starea lucrului stau în fișiere
Un asistent AI are o memorie de lucru limitată, numită fereastra de context. În ea intră tot ce s-a spus în conversație, fișierele citite și rezultatele comenzilor. Când se umple, conversația veche e comprimată într-un rezumat, iar detaliile se pierd. În după-amiaza aceea s-a întâmplat de două ori, la 15:34 și la 17:38.
Planul pe etape a stat într-un fișier separat. Starea lucrului a fost scrisă pe parcurs în memoria zilei: ce fișiere s-au schimbat, ce teste au trecut, ce decizii s-au luat, ce a mai rămas. În jurnal se vede ce a urmat. După prima comprimare, în mai puțin de un minut, sistemul a deschis memoria zilei și a citit starea. După a doua, a reluat din fișierele de lucru ale etapei în curs. La 15:41, la șapte minute după prima comprimare, a salvat o etapă. La 17:44, la șase minute după a doua, a salvat următoarea.
E diferența dintre un plan de șantier lipit pe perete și unul spus din gură la ședința de dimineață. Dacă șeful de echipă se schimbă la prânz, cel nou citește peretele și continuă.
2. Schimbarea se aplică întâi pe o copie
În a doua parte a după-amiezii, începând cu etapa despre înțelegerea mesajelor, fiecare schimbare a fost scrisă ca un script de aplicare, adică un mic program care face modificările în cod. Scriptul caută bucata veche de cod pe care vrea s-o înlocuiască și are o regulă strictă: bucata trebuie să apară exact o dată. Dacă apare de zero ori sau de două ori, scriptul nu scrie nimic și se oprește cu eroare.
Un chirurg marchează locul operației înainte să intre în sală. Dacă semnul nu e unde se aștepta, nu taie. La fel aici: o presupunere greșită despre cod iese la suprafață ca eroare, înainte să devină o modificare pusă în locul greșit.
Scriptul rula întâi pe o copie a proiectului. Proiectul real primea schimbarea după ce copia trecuse verificările, iar după aplicare cele două erau comparate fișier cu fișier, ca să fie sigur că în proiectul real a ajuns exact ce fusese testat.
La etapele de mai devreme, lucrurile au mers mai simplu: schimbările au intrat direct în proiect și au fost testate după aceea. Salvarea oficială a așteptat și acolo verificările, dar copia de protecție a apărut abia pe parcurs. O spun fiindcă e exact genul de detaliu care se pierde când povestești doar partea reușită.
Regula „exact o apariție” a prins chiar o greșeală a sistemului. La un moment dat, a încercat să corecteze automat un script de aplicare și a scris greșit câteva caractere speciale. Verificarea a refuzat scrierea. Nu s-a stricat nimic, iar corectura s-a făcut cu textul exact. Altă dată, proba pe copie a găsit o eroare de scriere într-un script care ar fi rupt tot fișierul. A găsit-o pe copie, deci proiectul real nu a fost atins.
3. Testele rulează pe un server, cu dubluri pentru lumea din afară
Testele pentru Studio au rulat pe serverul pilot, un server cu Ubuntu (sistemul de operare folosit de majoritatea serverelor), în copii separate de instalarea care rulează acolo. Motivul: pe server există ce există și la cumpărător, adică servicii care pornesc singure și programe reale care rulează în paralel. Testele pentru partea de licențe au rulat separat, pe o bază de date simulată.
Tot ce ține de lumea din afară a fost înlocuit cu dubluri. Un Telegram fals notează fiecare mesaj pe care i-l trimite Studio. Un Claude fals răspunde după un scenariu stabilit dinainte. Alte câteva programe false imită conexiunile la internet și serviciile serverului și înregistrează tot ce li se cere.
Ai văzut probabil manechinii din testele de impact de la mașini. Nimeni nu testează centura pe un om, dar manechinul are senzori care arată exact ce ar fi simțit omul. Dublurile fac același lucru: arată ce a făcut efectiv codul, dincolo de ce raportează el despre sine.
Protecțiile de securitate din Studio au fost testate după comportament. Pentru parola botului, de exemplu, testul pornește un program real și citește lista de programe a serverului, exact cum ar citi-o un program străin, ca să vadă dacă parola apare acolo. Oprirea lucrărilor s-a testat pe programe reale, inclusiv pe un proces zombi, adică un program deja terminat pe care sistemul de operare îl mai ține în evidență și care poate păcăli o verificare superficială. Lecția că o protecție se testează după ce face efectiv s-a reînvățat chiar în aceeași după-amiază, pe partea de licențe. Povestesc mai jos.
4. Testul testului: codul e stricat intenționat
Un test care trece nu dovedește mare lucru. Poate trece fiindcă totul e în regulă. Sau poate trece fiindcă, de fapt, nu verifică nimic.
Pentru protecțiile noi din majoritatea etapelor, sistemul a făcut copii în care a stricat intenționat câte o protecție. Apoi a rulat testele. Testul protecției trebuia să pice, din motivul corect. Dacă trecea și pe codul stricat, testul era slab și trebuia refăcut. Metoda se numește testare prin mutație, iar fiecare stricăciune intenționată e o mutație.
E exact ce faci cu o alarmă de fum: ții un chibrit aprins sub ea și vezi dacă sună. O alarmă pe care n-ai verificat-o niciodată cu fum e un obiect de decor.
Etapele verificate așa au avut între 5 și 21 de mutații fiecare. Etapa cu butoanele din Telegram a avut 21 și toate au fost prinse. Trei întâmplări din după-amiaza aceea arată cât de serios trebuie tratată verificarea:
- La o etapă, toate mutațiile au ieșit prinse. Rezultat perfect și, tocmai de aceea, suspect. La verificare, toate fuseseră prinse de două teste care picau oricum, din alt motiv. Rezultatul a fost aruncat, testul reparat și mutațiile rulate din nou.
- O mutație nu a schimbat nimic în comportament, fiindcă o altă verificare acoperea aceeași situație, deci codul stricat făcea același lucru ca cel bun. A fost scoasă din listă, cu motivul scris, ca să nu pară o scăpare.
- Mutațiile au rulat la început câte șase în paralel. Pe un server încărcat, testele care așteaptă câteva secunde după ceva pot pica din alte motive, iar atunci nu mai știi ce ai prins. Sistemul a coborât la trei.
5. Un al doilea AI, de la altă firmă, caută greșelile
Aici intră Codex. După fiecare etapă, sistemul i-a trimis codul nou cu o cerință simplă: găsește defecte medii sau grave și spune pentru fiecare fișierul, linia și un scenariu concret în care se strică ceva. În limbajul programatorilor, asta se numește review: verificarea codului de către altcineva decât autorul.
De ce un alt AI? Fiindcă greșeala se naște în capul celui care scrie, iar același cap o recitește apoi cu aceleași presupuneri. Un contabil bun își verifică singur calculele, și totuși firma plătește un auditor. Auditorul poate fi la fel de priceput ca el. Avantajul lui e că vede calculele pentru prima oară.
Nu am măsurat cât ar fi găsit Claude singur pe același cod, deci nu îți pot da o comparație. Îți pot spune ce a găsit Codex: defecte reale în toate etapele mari, după ce testele scrise de Claude treceau. Singura excepție a fost reparația din 17:32, unde a răspuns din prima că nu găsește nimic mediu sau grav.
Rundele au continuat până când Codex a răspuns că nu mai găsește nimic mediu sau grav. Au fost 6 runde pentru anunțarea lucrărilor întrerupte, 5 pentru înțelegerea mesajelor, 6 pentru actualizare, 4 pentru accesul la server și 6 pentru butoanele din Telegram.
Regula era ca fiecare constatare să fie verificată în cod înainte de a fi acceptată, apoi reparată pentru toată categoria ei și acoperită de un test nou. În practică, reparația pe categorie a venit uneori abia după ce aceeași problemă a apărut de mai multe ori. Butoanele din Telegram sunt exemplul cel mai clar.
Acolo, Codex a găsit de trei ori același tip de defect, în locuri diferite. Sistemul închidea o întrebare de clarificare veche înainte să fie sigur că pasul următor reușise. Dacă mesajul nou nu pleca (de exemplu, Telegram avea o pană de o secundă), omul rămânea fără întrebarea deschisă și fără vreun răspuns. Primele două dăți, sistemul a reparat locul arătat.
A treia oară a căutat toate locurile din cod cu aceeași formă și a găsit unul pe care Codex nu îl semnalase: situația în care serverul refuză o lucrare nouă fiindcă are deja prea multe în curs. Seara, la o nouă rundă, Codex a mai găsit un loc din aceeași familie. Căutarea pe categorie reduce scăpările, dar nu le elimină.
O constatare a fost respinsă. Codex cerea ca /ajutor să închidă o întrebare de clarificare aflată în așteptare. Doar că textul întrebării îl trimite chiar pe om la /ajutor, dacă nu știe ce să aleagă. Dacă /ajutor ar fi închis întrebarea, omul ar fi citit ajutorul și ar fi descoperit că întrebarea la care voia să răspundă dispăruse. Respingerea a fost scrisă în cod, cu motivul, și acoperită de un test care păstrează comportamentul.
Un sistem care execută orbește tot ce spune recenzorul e la fel de periculos ca unul care nu ascultă de nimeni.
6. Auditul pe codul deja salvat
Spre final, Codex a primit pentru audit o parte mare din codul Studio deja salvat: instalarea și bibliotecile de bază. Partea de Telegram fusese verificată separat, în rundele fiecărei etape. A găsit șapte defecte reale, dintre care trei încadrate ca grave. Sistemul le-a verificat pe fiecare în cod înainte să le accepte, fiindcă și recenzorul poate greși. Toate șapte s-au confirmat. Cinci s-au putut repara direct. Două au cerut o decizie de produs și au ajuns la mine, la 18:09.
Nu descriu defectele în articol. Reparațiile lor erau încă în verificări când l-am scris, iar o descriere ar fi o hartă pentru cine vrea să le caute.
Contează altceva: codul acela trecuse deja prin teste și prin review-uri. Auditul pe ansamblu găsește alte lucruri decât verificarea pe bucăți, la fel cum un inspector care vizitează toată casa vede probleme pe care nu le vede cel care a verificat camerele pe rând.
7. Ce nu se poate anula, așteaptă omul
Unele operații se pot anula oricând: o modificare de cod salvată se poate da înapoi. Altele au efect imediat în lumea reală, asupra oamenilor care folosesc sau descarcă produsul. Asta înseamnă producție, adică varianta live a unui sistem.
Toate operațiile de producție au rămas oprite până la confirmarea mea: urcarea pachetului Studio în spațiul din care îl descarcă cumpărătorii, publicarea serviciului de licențe și actualizarea serverului live.
Alte trei reguli au funcționat în fundal toată după-amiaza:
- Parolele și cheile de acces nu au fost afișate și nu au fost copiate pe laptop.
- În conversația mea reală de Telegram nu s-a trimis niciun mesaj de test. Testele au folosit Telegramul fals.
- Fiecare commit a inclus o listă explicită de fișiere. În același proiect lucrau în paralel și alte sesiuni ale mele, pe alte subiecte. Sistemul a salvat numai fișierele lui și nu a atins nimic din munca celorlalte, cum într-un birou comun îți iei de pe masă numai hârtiile tale.
Ce a mers prost
Ar fi necinstit să las impresia unei după-amiezi fără probleme. Au fost destule. Ce mă interesează la ele e cine le-a prins și ce s-a întâmplat după.
Uneltele și-au atins limitele
- Codex a atins limita de utilizare la 18:14 și a fost indisponibil până la 19:20. Etapa cu butoanele din Telegram era gata, cu testele trecute, și aștepta ultima rundă de review. A rămas nesalvată până atunci. Cât a așteptat, sistemul a scris și a testat pe o copie etapa următoare, cea cu reparațiile din audit.
- Codex rulează într-un mediu izolat, care nu avea voie să citească dosarul temporar al sesiunii. Sistemul a observat eroarea și a copiat fișierele de verificat într-un dosar din proiect.
- Documentația oficială Telegram pentru programatori a venit trunchiată prin unealta de citit pagini web. Sistemul a observat că lipsesc bucăți, a descărcat paginile direct și a citit secțiunile necesare înainte să scrie codul pentru butoane.
- Fereastra de context s-a umplut de două ori. Fără memoria scrisă pe parcurs, rezultatele testelor și deciziile de până atunci s-ar fi pierdut.
Un defect care apărea doar uneori
Una dintre cele mai interesante probleme a fost un defect intermitent, adică unul care apare doar uneori. Sistemul observase două teste care picau din când în când, fără legătură cu ce verificau. Putea să le ruleze din nou până treceau. În schimb, a pornit un experiment: aceeași suită de teste, pe aceeași copie, de trei ori în paralel. Două din cele trei rulări au picat, la teste diferite, la întâmplare.
Cauza ține de felul în care comenzile de pe server își dau rezultatele una alteia, ca pe o bandă rulantă. O verificare căuta un cuvânt în textul produs de o comandă și se oprea imediat ce îl găsea. Când se oprea, comanda dinainte, care încă trimitea text pe bandă, primea semnalul că nu mai ascultă nimeni la capăt (în jargon, SIGPIPE) și raporta o eroare.
Din cauza unor setări de siguranță, eroarea aceea putea face verificarea să spună „nu am găsit”, deși găsise. Totul depindea de care comandă termina prima, lucru care variază de la o rulare la alta. Iar unele verificări scrise invers („asigură-te că textul NU apare”) puteau, din același motiv, să treacă fals.
Partea gravă: în codul Studio existau zece locuri de felul ăsta, iar patru dintre ele decideau dacă un material trecuse verificarea înainte să fie publicat. Adică puteau da un rezultat fals exact acolo unde conta cel mai mult.
Reparația s-a făcut pentru toată categoria. Nicio verificare din cod nu mai folosește forma aceea, iar un test nou reproduce capcana la fiecare rulare, ca să nu se poată întoarce pe nevăzute. După reparație, aceleași trei rulări în paralel au ieșit toate trei curate.
Capcanele serverului
- Pe server, nici măcar administratorul (utilizatorul cu toate drepturile) nu poate suprascrie în dosarul temporar un fișier creat de alt utilizator. E o protecție a sistemului de operare. Consecința a fost că o rulare de mutații a folosit, fără să se vadă, o versiune veche a unui fișier. Sistemul a observat, a mutat lucrul într-un dosar propriu și și-a scris regula.
- O comandă compusă, scrisă pe un singur rând, a trimis în fundal mai mult decât trebuia, inclusiv niște valori pe care restul comenzii se baza. Acestea au rămas goale, iar o rundă de Codex nu a pornit. De atunci, valorile se stabilesc pe rânduri separate.
- Actualizarea Studio are o blocare care împiedică două actualizări să ruleze deodată. Blocarea era moștenită, din greșeală, de programele pornite din actualizare. Un program rămas agățat ar fi ținut blocarea și după terminarea actualizării, iar următoarea nu ar mai fi putut porni. L-a găsit Codex, s-a reparat și are acum un test.
Greșelile sistemului, prinse înainte de salvare
- Corectura automată cu caractere scrise greșit, refuzată de regula „exact o apariție”.
- Un test nou avea scris un simbol de rând nou ca text obișnuit, iar alt test primise un nume deja folosit. Ambele observate la citirea rezultatelor și corectate.
- O setare lăsată activă de un test ascundea un alt drum prin cod, așa că un test din altă secțiune verifica altceva decât credea. Descoperit fiindcă mutațiile „prinse” nu aveau sens.
- Un caracter pus direct într-o expresie de căutare rupea programul care citea scriptul. Prins pe copie, înainte să atingă proiectul real.
Cinci runde pe drumul greșit
Cea mai mare greșeală de judecată a zilei merită spusă separat. Sistemul avea de scris o verificare automată care să garanteze că panoul de administrare nu poate acorda acces la Studio din greșeală.
Prima variantă citea codul panoului și căuta anumite forme de scriere considerate periculoase. Codex a găsit o formă care o ocolea. Sistemul a schimbat abordarea și a urmărit în cod de unde se citesc valorile. Codex a găsit alte ocolișuri. Sistemul a trecut la o analiză a structurii codului, mai sofisticată. Codex a găsit din nou ocolișuri. Au fost cinci runde, cu trei variante din ce în ce mai complicate ale aceleiași idei: să verifice codul citindu-l.
Abia la a cincea rundă, sistemul a renunțat la idee. O verificare care citește codul ca pe un text va avea mereu ocolișuri, fiindcă același lucru se poate scrie în nenumărate feluri. A scris un test care rulează codul real al panoului, pe o bază de date simulată, în 122 de situații, și verifică ce se întâmplă efectiv. Pe codul vechi, testul pica în 79 din cele 122 de situații. Pe codul nou, trecea în toate.
În sistem există o regulă pentru exact asta: două reparații eșuate pe aceeași problemă înseamnă că diagnosticul e greșit. Sistemul a notat singur, în memoria zilei, că direcția trebuia schimbată încă de după a doua rundă. Regula exista și a fost aplicată cu întârziere. Îți spun asta fiindcă și un sistem autonom greșește. Ce contează e că își vede greșeala, o notează și o transformă într-o lecție pentru data viitoare.
Ce s-a întâmplat după 18:44
La 18:44 i-am cerut, înainte să continue, un raport despre cum a lucrat, din care am construit articolul ăsta. Apoi a mers mai departe.
- La 19:21, când Codex a revenit, a verificat ultimele două etape. La butoane a mai găsit un defect mediu, cel din familia descrisă mai sus. La etapa cu reparațiile din audit a găsit patru, toate reale, și după reparații încă unul.
- În codul nou pentru jurnale, testele au prins o greșeală din cauza căreia jurnalul serverului nu ar fi fost niciodată mutat deoparte când devine prea mare, deci ar fi crescut fără oprire pe serverul real.
- O mutație a blocat o rulare de teste timp de 30 de minute. Un program fals din test aștepta la nesfârșit o intrare care nu mai venea. Defectul era în test, deci s-a reparat testul, iar sistemul a verificat că pe server nu rămăsese niciun program agățat.
- Etapa cu butoanele din Telegram a fost salvată la 19:54, după șase runde de Codex și 21 de mutații, toate prinse.
Seara a mai adus un defect intermitent, care arată cel mai bine cum lucrează sistemul când nu știe răspunsul. La ultima etapă, 20 de mutații au ieșit „prinse”, dar jumătate dintre copii picau și la teste fără legătură cu mutația. Sistemul a declarat rezultatul nevalid și a căutat cauza.
A rulat din nou trei suite în paralel. Una a picat și, în locul Claude-ului fals, a pornit cel adevărat: dosarul temporar al suitei dispăruse în mijlocul rulării. Prima ipoteză despre cine îl ștergea a fost testată de 150 de ori și a căzut. A doua a căzut după o verificare a tot ce rulează pe server. A treia ipoteză spunea că un program oprit imediat după ce pornește apucă să execute curățenia programului care l-a pornit. Experimentul a reprodus exact situația: 299 de cazuri din 300 au șters dosarul. Cu o protecție adăugată, zero din 300.
Cauza era în suita de teste, iar codul care ajunge la cumpărători nu era afectat. Sistemul a reparat suita, a adăugat un test și o mutație pentru capcana asta și și-a notat lecția de metodă: după două ipoteze căzute, experimentul trebuie să reproducă exact condiția reală.
Când am scris articolul, ultima etapă, cea cu reparațiile din audit, era încă în verificări. Nu a fost salvată pe jumătate doar ca să iasă totul frumos la final.
Cum am ajuns aici: autonomia s-a construit din greșeli
Nimic din ce ai citit nu a existat din prima zi. robOS are primul commit pe 4 mai 2026 (și aici mă refer la versiunea 3, care a ieșit public!) și, la momentul scrierii, 660 de commituri. Multe dintre protecții s-au născut dintr-o greșeală concretă, care m-a costat ceva. Câteva merită povestite, fiindcă aici e răspunsul la întrebarea „cum ajungi să ai încredere”. Am mai lăsat AI-ul să lucreze singur și pe un blog, iar lecțiile de acolo sunt în articolul despre ce aș schimba la un blog autonom AI dacă aș începe de la zero.
Regula scrisă se pierde exact când ai nevoie de ea
La început, am făcut ce face oricine: i-am scris asistentului reguli într-un fișier pe care îl citește la fiecare pornire. Merge, până într-o zi. Pe 26 iulie, o regulă simplă de format, scrisă negru pe alb, a fost încălcată de două ori în aceeași zi, în două sesiuni lungi și grele.
Explicația e simplă. O regulă scrisă nu are prioritate. Stă în aceeași grămadă cu tot restul: sarcina curentă, fișierele deschise, istoricul conversației, alte zeci de reguli. Când memoria de lucru e aproape goală, regula se vede. Când e plină, se îneacă. Iar memoria e plină exact pe sarcinile grele, adică acolo unde regula contează.
Concluzia mea: ce trebuie să fie adevărat de fiecare dată se mută în cod. Pe instalarea mea, regula de format trăiește acum în trei mecanisme automate. Primul i-o amintește asistentului la fiecare mesaj. Al doilea refuză scrierile de fișiere care o încalcă, cu câteva zone scutite. Al treilea citește răspunsul final și îl blochează până e rescris corect, de cel mult trei ori pe sesiune, ca să nu intre într-o buclă. Diferența e ca între un afiș cu „închideți ușa” și o ușă care se închide singură.
Mecanismele de felul ăsta se numesc hook-uri: programe care pornesc automat la un anumit moment (la fiecare mesaj, înainte de o scriere, înainte de o comprimare a conversației), indiferent dacă asistentul își amintește de ele sau nu. Am scris despre o regulă de felul ăsta și în articolul despre linia urâtă din prompturile mele.
Patru incidente care au devenit mecanisme
- 14 iulie, citatele. Am livrat un material cu pasaje marcate drept citate exacte dintr-o sursă. O parte nu erau exacte. I-am cerut asistentului să recitească și a spus că e totul în regulă, fiindcă greșeala se produsese chiar în capul care verifica. Acum, când sursa brută e disponibilă, citatele marcate ca exacte trec printr-un script care le compară cuvânt cu cuvânt cu sursa și semnalează fiecare nepotrivire.
- 26 iulie, regula de format. Povestea de mai sus, din care au ieșit cele trei mecanisme automate.
- 31 iulie, ștergerea. La o cursantă care folosea robOS, asistentul a șters un document Word fără să întrebe. De atunci, comenzile de ștergere date de asistent în terminal trec printr-o poartă: în zonele importante sunt refuzate, în zonele de lucru temporar trec, iar în rest cer confirmare. Fișierele generate de sistem se mută într-un coș din care pot fi recuperate timp de 45 de zile. Iar înainte ca o comandă obișnuită să suprascrie un fișier, de cele mai multe ori se păstrează automat o copie. E o plasă de siguranță cu limite scrise, fără pretenția de garanție.
- 28 august, documentul „verificat în întregime”. Am livrat un document tehnic cu un antet care spunea că toate calculele sunt verificate. Sub antet, calculele chiar testate stăteau amestecate cu afirmații luate din memoria modelului, iar una dintre ele era falsă. Antetul le acoperea pe toate cu aceeași garanție. Acum fiecare afirmație-cheie își declară separat statutul (verificată, cu sursă, sau doar presupusă), un script refuză antetele globale de tipul ăsta, iar înainte de livrare un context separat, care nu a produs documentul, încearcă să-l demonteze. E aceeași idee ca la Codex: verifică cineva care nu a scris.
Memoria care supraviețuiește
Ai văzut că după-amiaza a trecut peste două comprimări ale conversației. Asta a fost construit dinainte. robOS are mai multe straturi de memorie: memoria zilei, cu ce s-a livrat, ce s-a decis și ce a rămas deschis; o memorie de lucru scurtă, încărcată la fiecare pornire; și o bază de note în care rămân lecțiile de durată.
Înainte de fiecare comprimare, un hook scrie automat starea proiectului într-un fișier: ce fișiere sunt modificate, unde e memoria zilei, ce fire sunt deschise. La primul mesaj de după comprimare, asistentul primește blocul ăsta în față. Partea pe care hook-ul nu o poate citi din conversație, deciziile și rezultatele testelor, o scrie asistentul pe parcurs, fiindcă așa îi cer regulile.
Regulile de comportament
Pe lângă mecanismele automate, sistemul are câteva reguli de comportament. Pe unele le-ai văzut la lucru în după-amiaza aceea, uneori aplicate cu întârziere:
- Când întrebi, închizi bucla. Întâi faci tot ce nu depinde de răspuns, apoi pui o întrebare și aștepți răspunsul real. Nu îți răspunzi singur și nu mergi mai departe pe o presupunere.
- Două reparații eșuate pe aceeași problemă înseamnă diagnostic greșit. Te oprești din peticit și verifici presupunerea de sub ele.
- Repari categoria, pe lângă exemplul găsit. Când apare o greșeală, cauți toate locurile cu aceeași formă.
- Citești înainte să modifici și testezi după. Dacă nu ai putut testa, spui explicit asta.
- Operațiile care nu se pot lua înapoi cer confirmare. Ștergeri, producție, trimiteri în afară.
- Scopul e cererea. O problemă observată pe drum, care nu ține de sarcină, se raportează la final și nu se repară pe ascuns în aceeași schimbare.
Fiecare corecție devine o regulă
Ultima piesă e cea care face ca celelalte să crească în timp. Când corectez sistemul, regula lui e să caute cauza reală a greșelii, să scrie o regulă în locul potrivit și să-mi confirme ce a notat. O regulă care ține de o singură unealtă ajunge în lecțiile acelei unelte și i se arată automat data viitoare când unealta pornește. O regulă generală ajunge în regulile de bază. Iar când aceeași problemă apare a doua oară, regula mea e ca soluția să se mute din text în cod. Nu am reușit încă pentru toate: în articolul despre prompturi am povestit o regulă importantă care e tot doar text.
E diferența dintre un asistent care uită și unul care învață. Autonomia din 13 septembrie e rezultatul a patru luni de corecturi de felul ăsta.
Ce nu poate un agent AI autonom și unde are nevoie de tine
Ca să fie clar ce ai citit și ce nu ai citit:
- Nu e magie și nu s-a întâmplat peste noapte. În spate sunt patru luni de reguli, incidente și reparații.
- Omul rămâne la decizii. Cele cinci întrebări din acea zi au fost decizii de produs pe care sistemul nu avea de unde să le ia corect singur: cât acces primește un cumpărător, cât de strict separăm lucrurile, ce păstrăm și ce ștergem.
- O unealtă externă îl poate bloca. Când Codex și-a atins limita, o etapă gata a așteptat mai bine de o oră.
- Regulile se aplică imperfect. Copia de protecție a apărut abia la jumătatea după-amiezii, reparația pe categorie a venit uneori la a treia apariție, iar diagnosticul greșit a ținut cinci runde. Mecanismele reduc greșelile și le fac vizibile, fără să le elimine.
- Rezultatul e la fel de bun ca verificările lui. Un test slab trece și pe codul stricat, de aceea există mutațiile. Cine a scris codul îl citește cu aceleași presupuneri, de aceea există Codex. Iar testele pot avea și ele defecte, cum ai văzut seara. Fiecare verificare are nevoie, la rândul ei, de o verificare.
Ce poți lua de aici, chiar dacă nu folosești robOS
Regulile de mai sus nu țin de o anumită unealtă. Se aplică oricărei delegări, fie că îi dai o sarcină unui agent AI autonom, fie unui om din echipa ta:
- Planul se scrie. Într-un loc pe care îl poate citi oricine preia lucrul.
- Lucrezi întâi pe o copie. Originalul se atinge după ce copia a trecut verificările.
- Verifică altcineva decât cel care a făcut. Un coleg, un auditor, un al doilea AI.
- Te oprești înainte de ce nu se mai poate lua înapoi. Plăți, publicări, ștergeri, trimiteri către clienți.
- Verifici că verificarea chiar prinde ceva. Strică intenționat o dată și vezi dacă alarma sună.
Și o regulă pentru tine, ca om care deleagă: lasă-te întrebat la decizii și scutește-te de detalii. Dacă ești întrebat de toate, nu ai delegat nimic. Dacă nu ești întrebat de nimic, cineva decide în locul tău lucruri pe care nu ar trebui să le decidă.
Dacă alegi un furnizor care îți construiește agenți AI, întrebările din articolul despre cum alegi un furnizor de agenți AI te ajută să afli dacă are asemenea verificări sau doar o demonstrație frumoasă. Despre agenți AI care rulează deja în producție la firme mari am scris în articolul despre Deutsche Telekom și Swisscom.
Întrebări frecvente
Ce este un agent AI autonom?
Un agent AI autonom e un program bazat pe un model AI care primește o sarcină și o duce singur la capăt, în mai mulți pași: citește, decide, rulează comenzi, verifică rezultatul și corectează. Diferența față de un chat e că nu așteaptă câte o instrucțiune pentru fiecare pas. Cât de mult îl poți lăsa singur ține de cât de bune sunt limitele și verificările din jurul lui.
Poate un agent AI autonom să lucreze singur ore întregi?
Da, cu condiții. În cazul din articol, sistemul a lucrat 4 ore și 51 de minute, cu 698 de acțiuni și două momente în care a cerut o decizie. A fost posibil fiindcă planul și starea lucrului stăteau în fișiere, iar schimbările treceau prin teste, prin testare prin mutație și prin review-ul unui al doilea AI înainte să fie salvate.
Cum împiedici un agent AI autonom să strice ceva?
Prin limite care nu depind de memoria sau de bunăvoința lui. Schimbările se aplică întâi pe o copie, se testează pe un server, testele sunt verificate prin stricare intenționată, iar codul e revizuit de un alt AI. Ștergerile trec printr-o poartă automată, iar operațiile de producție așteaptă confirmarea omului. Niciuna dintre ele nu e perfectă singură, de aceea sunt mai multe.
Ce este testarea prin mutație, pe înțelesul tuturor?
E verificarea testelor. Strici intenționat o bucată de cod și rulezi testele. Dacă testul care ar trebui să apere acea bucată trece și pe codul stricat, testul nu verifică nimic și trebuie refăcut. E echivalentul verificării unei alarme de fum cu fum adevărat.
De ce ai folosit Codex, dacă robOS rulează pe Claude?
Fiindcă cine a scris codul îl recitește cu aceleași presupuneri cu care l-a scris. Codex vine de la altă firmă și nu a văzut conversația, deci citește codul fără istoria deciziilor care l-au produs. Instrucțiunile pentru el au fost scrise tot de sistem, deci independența nu e totală. În sesiunea descrisă a găsit totuși defecte reale în toate etapele mari, după ce testele treceau.
Ce se întâmplă când AI-ul își pierde memoria conversației?
Conversația veche e comprimată într-un rezumat și detaliile se pierd. Soluția e ca tot ce contează să fie scris în fișiere pe parcurs, iar un mecanism automat să salveze starea înainte de comprimare. În sesiunea din articol s-a întâmplat de două ori, iar etapa următoare a fost salvată la șapte, respectiv șase minute după.
Ce e robOS și cui îi folosește?
robOS e sistemul de lucru pe care l-am construit peste Claude Code: memorie de la o zi la alta, reguli de lucru, unelte specializate și porți de siguranță. Îl folosesc zilnic pentru munca mea și îl vând celor care vor să lucreze la fel. Detaliile sunt pe robos.vip.
Pe scurt
Într-o după-amiază, robOS a lucrat ca agent AI autonom aproape cinci ore pe un produs nou, a salvat șapte etape din plan plus o reparație găsită pe drum și m-a întrebat numai ce era decizia mea. Forța vine din ce stă în jurul modelului: planul scris, copia înainte de original, testele verificate prin stricare, al doilea AI care caută greșeli și oprirea înainte de orice nu se mai poate lua înapoi. Niciuna nu e perfectă, și ai văzut unde au scăpat lucruri. Împreună, au făcut ca greșelile să iasă la suprafață înainte să ajungă la cineva.
Dacă vrei să vedem cum ar arăta un asemenea mod de lucru în firma ta, scrie-mi pe WhatsApp la +40 775 341 146 sau la office@robomarketing.ro.
Intrebari frecvente
Ce este un agent AI autonom?
Un agent AI autonom e un program bazat pe un model AI care primește o sarcină și o duce singur la capăt, în mai mulți pași: citește, decide, rulează comenzi, verifică rezultatul și corectează. Diferența față de un chat e că nu așteaptă câte o instrucțiune pentru fiecare pas. Cât de mult îl poți lăsa singur ține de cât de bune sunt limitele și verificările din jurul lui.
Poate un agent AI autonom să lucreze singur ore întregi?
Da, cu condiții. În cazul din articol, sistemul a lucrat 4 ore și 51 de minute, cu 698 de acțiuni și două momente în care a cerut o decizie. A fost posibil fiindcă planul și starea lucrului stăteau în fișiere, iar schimbările treceau prin teste, prin testare prin mutație și prin review-ul unui al doilea AI înainte să fie salvate.
Cum împiedici un agent AI autonom să strice ceva?
Prin limite care nu depind de memoria sau de bunăvoința lui. Schimbările se aplică întâi pe o copie, se testează pe un server, testele sunt verificate prin stricare intenționată, iar codul e revizuit de un alt AI. Ștergerile trec printr-o poartă automată, iar operațiile de producție așteaptă confirmarea omului. Niciuna dintre ele nu e perfectă singură, de aceea sunt mai multe.
Ce este testarea prin mutație, pe înțelesul tuturor?
E verificarea testelor. Strici intenționat o bucată de cod și rulezi testele. Dacă testul care ar trebui să apere acea bucată trece și pe codul stricat, testul nu verifică nimic și trebuie refăcut. E echivalentul verificării unei alarme de fum cu fum adevărat.
De ce ai folosit Codex, dacă robOS rulează pe Claude?
Fiindcă cine a scris codul îl recitește cu aceleași presupuneri cu care l-a scris. Codex vine de la altă firmă și nu a văzut conversația, deci citește codul fără istoria deciziilor care l-au produs. Instrucțiunile pentru el au fost scrise tot de sistem, deci independența nu e totală. În sesiunea descrisă a găsit totuși defecte reale în toate etapele mari, după ce testele treceau.
Ce se întâmplă când AI-ul își pierde memoria conversației?
Conversația veche e comprimată într-un rezumat și detaliile se pierd. Soluția e ca tot ce contează să fie scris în fișiere pe parcurs, iar un mecanism automat să salveze starea înainte de comprimare. În sesiunea din articol s-a întâmplat de două ori, iar etapa următoare a fost salvată la șapte, respectiv șase minute după.
Ce e robOS și cui îi folosește?
robOS e sistemul de lucru pe care l-am construit peste Claude Code: memorie de la o zi la alta, reguli de lucru, unelte specializate și porți de siguranță. Îl folosesc zilnic pentru munca mea și îl vând celor care vor să lucreze la fel. Detaliile sunt pe robos.vip.