
Jev AI este un model de inteligență artificială care alege: primește o situație și îți dă răspunsul dintr-o listă făcută de tine, cu o probabilitate pentru fiecare variantă. E gândit pentru decizii mici, luate de mii de ori pe zi.
L-a lansat TypeSafe AI pe 15 septembrie 2026. Prețul listat e 0,042 dolari pe milionul de tokeni citiți (un token e o bucată de cuvânt, unitatea după care plătești, cum plătești benzina la litru). L-am pus la treabă pe 193 de cereri reale scrise în română: la cererile care chiar cereau ceva, a nimerit 21 din 25.
Articolul e pentru cine a auzit de Jev AI și vrea să afle, înainte să-l pună în producție, ce face, cât costă și unde greșește. Mai jos găsești testul nostru, prețurile, limitele recunoscute chiar de producător și ce au măsurat alții în prima săptămână.
Jev AI pe scurt: ce este și cine l-a făcut
Jev AI este primul model „System One” al firmei TypeSafe AI, fondată de Diogo Almeida, care a lucrat la OpenAI la cercetarea din spatele ChatGPT (asistentul de chat al OpenAI). Modelul primește text sau date structurate și răspunde doar la întrebări cu variante stabilite dinainte. Pentru fiecare variantă îți dă o probabilitate, iar programul tău decide ce face cu ea.
Gândește-te la un funcționar de ghișeu cu trei ștampile: DA sau NU, „la ghișeul 2” și o notă de la 1 la 5. Ștampilează repede și ieftin. Un model de chat (LLM, programul care scrie text cuvânt cu cuvânt) seamănă cu secretara care redactează scrisori. Pentru o decizie mică, repetată de mii de ori, îți trebuie ghișeul.
Testul nostru: Jev AI pe 193 de cereri în română
Am luat 193 de cereri reale pe care le-am scris eu în robOS, sistemul meu de lucru cu AI, și am întrebat patru sisteme ce rețetă trebuie pornită pentru fiecare. Pe cererile care chiar cereau o rețetă, Jev AI a nimerit 21 din 25, dispecerul nostru pe cuvinte-cheie 16. Jev a pornit însă mai des ceva inutil.
Contextul: robOS are 121 de rețete, adică proceduri scrise o dată și rulate de fiecare dată când e nevoie (un articol, o factură, un raport). La fiecare cerere, un dispecer alege rețeta după cuvinte-cheie. Cererile sunt în română, cu greșelile mele de tastare, fără date de clienți.
Concurenții au fost patru:
- dispecerul de azi, pe cuvinte-cheie
- Jev, cu o singură întrebare: ce rețetă pornești, sau niciuna
- Jev, cu întrebarea împărțită în două: „ceri să se facă ceva acum?”, apoi alegerea rețetei
- gpt-6-luna, un model mic de chat de la OpenAI, pus să aleagă prin text
Răspunsurile corecte au fost stabilite de două ori. Prima dată văzând alegerea dispecerului, deci cu o înclinare spre el. A doua oară de un model AI separat, care nu a văzut ce a ales niciun concurent și putea da și o a doua variantă acceptabilă. Niciun om nu a verificat toate etichetele. Cifrele de mai jos sunt pe varianta oarbă.
Un avertisment înainte de cifre: doar 25 din 193 de cereri cereau efectiv o rețetă. Un sistem care ar răspunde mereu „nimic de pornit” ar avea aproape 90% răspunsuri corecte. De aceea procentul general nu spune mare lucru, iar eu măsor separat cele două tipuri de cereri.
- Dispecerul pe cuvinte-cheie: rețeta corectă la 16 din 25 de cereri reale. A pornit ceva inutil la 10 din 168 de mesaje care nu cereau nimic.
- Jev, o întrebare: rețeta corectă la 21 din 25. A pornit ceva inutil la 23 din 168.
- Jev, cu întrebarea împărțită: 15 din 25, cu 16 porniri inutile din 168.
- gpt-6-luna: 22 din 25, cel mai bun scor pe cererile reale, dar a pornit ceva inutil la 69 din 168 de mesaje fără cerere.
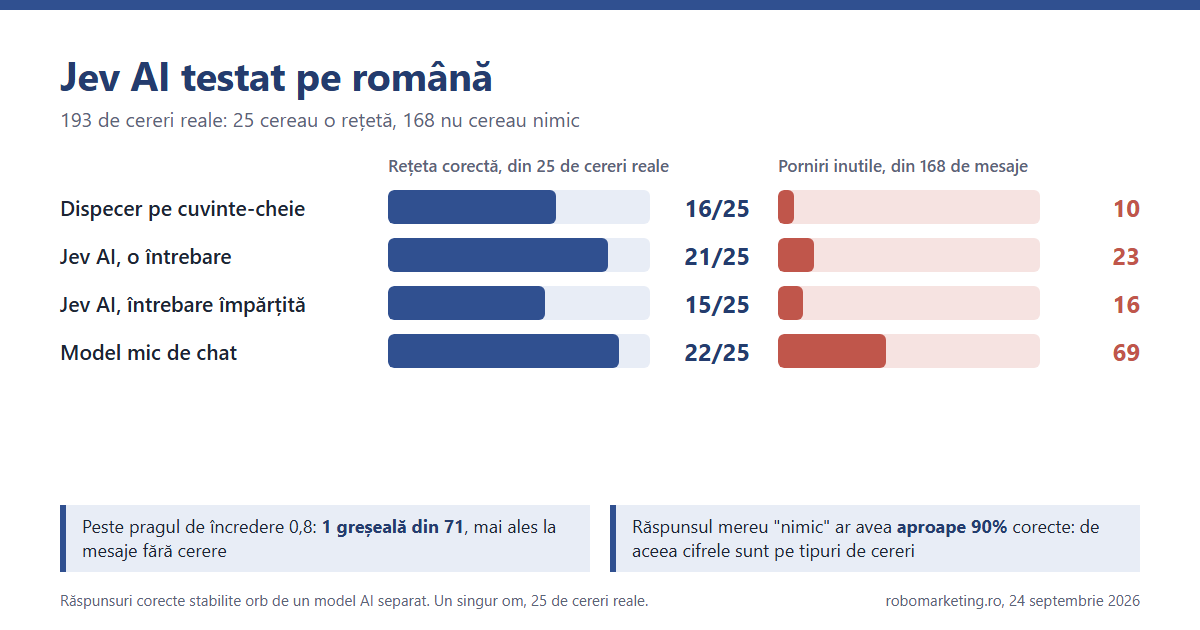
Pe etichetele făcute văzând alegerea dispecerului, avantajul lui Jev pe cererile reale dispare: 18 din 33, față de 19 din 33 la dispecer. Pe ambele seturi rămâne însă același tipar: Jev pornește ceva inutil de peste două ori mai des decât dispecerul.
Jev spune la fiecare alegere cât de sigur e. Peste pragul de 0,8, adică la 71 de cereri, a greșit o singură dată. Cifra ascunde ceva: 62 dintre ele erau mesaje la care răspunsul corect era „nimic de pornit”. La rețete propriu-zise, peste prag au rămas 9, dintre care 8 corecte.
Jev a răspuns în 0,63 secunde pe cerere, față de circa 3 secunde la modelul de chat, iar tot testul a costat vreo 8 cenți.
Cum citesc eu rezultatul: dispecerul a jucat pe teren propriu. Cuvintele lui cheie au fost reglate pe cererile mele, ultima dată chiar în dimineața testului, pe greșeli găsite în același jurnal. Jev a lucrat fără niciun exemplu rezolvat. Pe română, nivelul lui e comparabil, cu alt tip de greșeală.
Limitele testului, spuse direct: cererile sunt ale unui singur om, doar 25 cer efectiv o rețetă, jurnalul păstrează primele 300 de caractere din fiecare cerere, instrucțiunile pentru Jev au fost în engleză, iar evaluatorul orb e tot un model AI. Pe alt sistem, cifrele pot ieși altfel.
Cele trei tipuri de întrebări pe care le înțelege Jev AI
Jev AI acceptă trei tipuri de întrebări: da sau nu (noul, în documentația lor), alegerea unei variante dintr-o listă de până la 255 (choice) și o poziție pe o scară descrisă de tine (score). Fiecare răspuns vine cu probabilitatea lui, iar alegerea și scara au în plus un scor de încredere.
Regula de alegere: dacă programul acționează sau nu, pui da sau nu. Dacă trimite cererea undeva, pui o alegere. Dacă sortează, o scară.
Un detaliu care contează când scrii cod: la întrebarea da sau nu nu există scor de încredere separat, doar probabilitatea, iar pragul îl pui direct pe ea. Scrie asta în documentația TypeSafe despre noul.
Poți pune mai multe întrebări în același apel. Plătești citirea situației o singură dată, iar întrebările se rezolvă în paralel. În testul meu, ambele întrebări (ceri ceva? ce rețetă?) au plecat în același apel.
Ce înseamnă, concret, că Jev AI „nu halucinează”
Înseamnă un singur lucru: modelul nu poate da un răspuns din afara listei tale. Poate alege însă varianta greșită din listă. Un comentator din discuția de pe Hacker News (forumul unde discută programatorii) a rezumat exact asta: forma răspunsului e garantată, iar conținutul lui poate fi greșit.
De aceea pragul de încredere contează. În testul meu, peste pragul de 0,8 a greșit o singură dată din 71, mai ales pe cazuri ușoare. Sub prag, un om sau un model mai scump trebuie să se uite.
Cât costă Jev AI și cât de repede răspunde
Prețul listat e 0,042 dolari pe milionul de tokeni de intrare, iar răspunsul e gratuit. O mie de emailuri de câte 500 de tokeni înseamnă o jumătate de milion de tokeni, adică circa 2 cenți pentru tot lotul. Latența (cât durează până primești răspunsul) a fost de 0,26 secunde, mediana măsurată de OpenRouter.
OpenRouter e un intermediar care îți dă acces la multe modele AI prin același cont. Prețul și modelele apar pe pagina TypeSafe de pe OpenRouter. Limitele de trafic sunt 250.000 de tokeni pe secundă și 1.200 de cereri pe minut, cu mențiunea că se pot schimba fără preaviz, după pagina de modele.
O cerere poate avea până la 64.000 de tokeni la TypeSafe, dar textul analizat plus cea mai lungă întrebare au maximum 32.000. Prin OpenRouter și Cloudflare, limita listată e 32.000. Asta e contextul, adică tot ce încape pe masă odată.
Cum se citește „de 444 de ori mai ieftin”
TypeSafe spune că Jev AI e de 444,6 ori mai ieftin și de 193,6 ori mai rapid. Cifrele vin din evaluarea lor și au termeni de comparație diferiți: costul e raportat la Opus 5, cel mai scump model din tabel, iar viteza la Sonnet 5. Față de un model ieftin comparabil, diferența e mult mai mică.
În același tabel de evaluare TypeSafe, Jev ia 67,8% cu 0,0004 dolari pe caz, iar Luna ia 66,8% cu 0,0033 dolari. Diferența de cost e de circa 8 ori, cu un punct de acuratețe între ele.
Un detaliu de metodă, recunoscut de producător: „acuratețea” din tabel înseamnă acord cu răspunsurile a două modele mari, GPT-6 Astra și Fable 5.1. Oamenii nu au verificat etichetele, aceeași limită pe care o are și testul nostru. Regula pe care o aplic la orice furnizor: la un multiplicator, întreb mereu „față de ce?”.
Unde e bun și unde pierde Jev AI, după evaluarea producătorului
Pe cele patru fluxuri din evaluarea TypeSafe, Jev AI e foarte bun la suportul pentru clienți și slab la facturi și la incidentele de securitate. La suport ia 76,0%, peste unele modele mult mai scumpe. La procesarea facturilor ia 61,8%, cu peste 17 puncte sub cel mai bun model din tabel.
- suport pentru clienți: 76,0% (cel mai bun model: 78,3%)
- urmărirea pașilor unui agent AI: 71,6%, sub Luna (76,1%), un model ieftin, dar de 8 ori mai scump decât Jev
- incidente de securitate: 61,7%
- facturi: 61,8%, față de 79,1% la vârf
Tiparul se potrivește cu limitele declarate: tare pe judecata asupra textului, slab unde contează numerele și datele. Facturile sunt exact cazul cu numere. Dacă te gândești la un asistent pentru suport, am scris separat despre chatboți AI și asistenți virtuali.
Ce arată testele independente din prima săptămână
Testele făcute de alții în prima săptămână după lansare îl pun pe Jev AI la nivelul modelelor de preț mediu, în urma celor de vârf. Merge foarte bine pe sarcini clare și repetitive și pierde acolo unde contează ordinea sau nuanța.
- Un studiu pre-înregistrat, pe 7.977 de exemple etichetate de oameni, îl găsește sub cel mai bun dintre 19 modele în 14 din 15 sarcini, la o diferență mediană de 11,6 puncte de macro-F1 (o notă care ține cont și de categoriile rare), după sinteza de pe dev.to.
- Un filtru care oprește un „gata” nedovedit al unui agent de programare a atins AUROC 0,976 (o notă de la 0,5, dat cu banul, la 1, perfect).
- Un test pe 9.081 de perechi de produse (e același produs sau nu?) a costat în total 0,32 dolari.
- La ordonarea rezultatelor de căutare într-un magazin online, a picat 4 din 6 praguri de calitate.
Pe română, testul de mai sus e primul public de care știm.
De unde vine câștigul real: întrebarea tăiată în bucăți
La Jev, câștigul mare vine din felul în care pui întrebarea. Într-un test pe emailuri de phishing (emailuri-capcană), Jev a avut 62,6% răspunsuri corecte cu o întrebare generală și 95,0% cu cinci întrebări mici, cu ponderi reglate pe 1.000 de exemple etichetate.
La Haiku 4.5, un model mic de chat, lucrurile au stat altfel. A pornit de la 81,3%, iar combinația celor cinci întrebări a ajuns la 93,2%, dar, după autorul testului, cel mai bun semnal luat singur a fost și mai bun. Descompunerea a ajutat în primul rând modelul care alege.
În testul meu pe română, întrebarea în plus „ceri să se facă ceva acum?” a scăzut pornirile inutile ale lui Jev de la 23 la 16 din 168. A crescut în schimb numărul de cereri reale ratate. Descompunerea e un buton de reglat, cu un preț.
Cum folosești Jev AI ca să iasă ceva: ghidul lor, pe scurt
Ghidul de proiectare din documentația TypeSafe se rezumă la câțiva pași care țin și fără Jev AI. Ce se poate scrie ca regulă fixă rămâne în cod. Modelul primește doar informația care contează pentru decizie și răspunde la întrebări mici, puse toate deodată.
- Ce poate fi scris ca regulă fixă (un simplu „dacă”) rămâne regulă fixă.
- Modelul primește doar ce contează pentru decizie. Informația în plus îi scade acuratețea.
- Întrebarea mare se taie în întrebări mici.
- Toate întrebările pleacă în același apel.
- Răspunsurile se combină în cod, cu ponderi alese de tine.
- Sub un prag de încredere decide un om. Peste prag, decide programul.
- Pragurile se stabilesc pe exemple verificate de tine.
Înainte de producție, fă-ți un set de o sută de cazuri cu răspunsul corect știut. Rulezi Jev AI și alternativa pe el și compari. Aceeași disciplină o aplic la automatizarea proceselor dintr-o firmă: fără setul de verificare nu știi dacă ai schimbat costul pe greșeli.
Ce nu știe să facă Jev AI
TypeSafe publică o pagină cu nouă moduri de eșec pentru versiunea jev-1.13, și merită citită înaintea oricărui test. Pe scurt: citește întrebarea ad litteram, e nesigur la calcule și la compararea datelor calendaristice și poate fi păcălit de un text scris special pentru asta.
- Sume, numărat, date: nu-l pui să calculeze sau să compare.
- Negațiile duble și raționamentul în mai mulți pași îi scad acuratețea.
- Multă informație fără legătură cu decizia îi scade și ea acuratețea.
- O întrebare și negația ei nu dau împreună 1: în exemplul lor, 0,72 plus 0,47 fac 1,19.
- Nu generează text și nu rezumă.
Lista completă e pe pagina de limite jev-1.13. Pentru limbă, documentația spune că engleza merge cel mai bine și îți recomandă să testezi pe conținutul tău înainte să te bazezi pe alt text. Exact asta am făcut mai sus.
Cum ajungi la Jev AI și ce se întâmplă cu datele tale
Ai patru căi: direct la TypeSafe, prin OpenRouter, prin Vercel AI Gateway (un intermediar asemănător, al firmei Vercel) sau prin Cloudflare Workers AI (serviciul de modele AI al Cloudflare). Pe 24 septembrie, când am încercat să-mi fac cont, consola TypeSafe mi-a afișat „Whoops, we’re full”, așa că am mers prin Cloudflare.
Două detalii practice. Pe Cloudflare, Jev AI e modelul altei firme, iar tokenul de acces are nevoie de dreptul Workers AI. Contul are nevoie de credit încărcat în AI Gateway, zona de facturare pentru modelele terților. Fără credit, am primit eroarea „Insufficient balance”.
Cloudflare ia 5% la încărcarea creditului, după documentația de facturare. Iar răspunsul ne-a venit împachetat de două ori, deși exemplul din documentație arată un singur nivel.
API-ul e ghișeul la care programul tău trimite cererea. Pentru n8n (platforma de automatizări) nu există încă un nod oficial, deci calea sigură e nodul HTTP Request, cu cererea trimisă direct la API. Dacă lucrezi cu automatizări în agenție, am adunat mai multe într-un ghid pentru agenții și IMM-uri.
Datele: TypeSafe spune că nu antrenează modelul pe cererile clienților, iar păstrarea zero a datelor e disponibilă pe planul enterprise. Pentru mesajele clienților trimise în SUA, ai nevoie de un acord de prelucrare a datelor cu furnizorul (contractul care spune ce face cu ele) și de o bază legală pentru transfer. Discută asta cu consultantul tău GDPR.
Modelul nu se poate instala la tine, fiindcă nu există greutăți de descărcat (fișierele modelului). Depinzi deci de un singur furnizor, care a avut cinci incidente între 16 și 23 septembrie, după pagina lui de status.
Ce spun criticii
Obiecția principală de pe Hacker News: n-ar fi nimic nou, fiindcă alegerea între variante fără exemple rezolvate (clasificare zero-shot, cam ca un candidat care dă testul fără să fi văzut vreun exemplu) se face de ani de zile cu modele deschise. E o obiecție serioasă, iar testul meu nu o contrazice.
A doua obiecție privește cifrele. TypeSafe a declarat că nu publică rezultate pe testele standard din industrie și preferă ca fiecare să-și facă propriile teste. Suspiciunea e de înțeles. Pagina lor de limite arată totuși o firmă care își spune singură punctele slabe.
Pentru context: firma a ieșit din anonimat cu o finanțare de 40 de milioane de dolari, condusă de fondul DCVC.
Când merită Jev AI și când nu
Jev AI merită la decizii mici luate în volum mare, la decizii care trebuie luate sub o secundă și la acțiuni automate unde ai nevoie de o probabilitate după care să pui un prag. Nu merită la sume, date calendaristice sau numărat și nici la volume mici, unde prețul nu contează.
Recomandarea mea, după test: lasă pe loc sistemul care merge deja și testează Jev AI pe datele tale înainte de orice. La noi, varianta mixtă, cu dispecerul întâi și Jev doar unde dispecerul tăcea, n-a adus nimic peste un prag prudent: exact acolo, Jev era nesigur.
Pentru varianta pe limba patronului, fără tehnică, am scris un ghid despre AI pe WhatsApp Business și fișa de decizie. Exemple de automatizări care rulează la clienți găsești în studiile de caz, iar pentru mesaje am o pagină despre automatizarea WhatsApp Business.
Dacă vrei să vedem împreună unde ar merge un model ca Jev AI în firma ta, scrie-mi pe WhatsApp.
Întrebări frecvente despre Jev AI
Ce este Jev AI?
Jev AI este un model de inteligență artificială lansat de TypeSafe AI pe 15 septembrie 2026. Primește o situație și alege răspunsul dintr-o listă dată de tine, cu o probabilitate pentru fiecare variantă. E făcut pentru decizii mici, repetate de mii de ori, unde contează viteza, costul și un prag de încredere.
Cine a făcut Jev AI?
Modelul e făcut de TypeSafe AI, o firmă fondată de Diogo Almeida, care a lucrat la OpenAI la cercetarea din spatele ChatGPT. Firma a lucrat doi ani fără să iasă public și a pornit cu o finanțare de 40 de milioane de dolari, condusă de fondul de investiții DCVC.
Cât costă Jev AI?
Prețul listat e 0,042 dolari pe milionul de tokeni citiți, iar răspunsul e gratuit. O mie de emailuri scurte costă circa 2 cenți. Testul nostru pe 193 de cereri a costat vreo 8 cenți, fiindcă fiecare cerere purta lista celor 121 de rețete. Prin Cloudflare mai plătești 5% la încărcarea creditului.
Jev AI este un LLM?
Nu în sensul obișnuit. Un LLM scrie text cuvânt cu cuvânt, pe când Jev împarte probabilități între variantele pe care i le dai și alege una. Criticii spun că seamănă cu un clasificator fără exemple, cunoscut de ani de zile. Diferența promisă de producător e o încredere care se potrivește cu realitatea.
Jev AI este open source?
Nu. Modelul se folosește doar prin API, la TypeSafe sau prin OpenRouter, Vercel și Cloudflare, iar fișierele modelului nu se pot descărca. Au apărut câteva proiecte deschise care pretind că îl egalează, dar niciunul nu fusese validat independent la sfârșitul lui septembrie 2026.
Merge Jev AI pe limba română?
Da, cu limite. În testul nostru pe 193 de cereri reale în română, Jev AI a găsit rețeta corectă la 21 din 25 de cereri care cereau una, dar a pornit ceva inutil la 23 din 168 de mesaje care nu cereau nimic. Testează-l pe textele tale înainte să te bazezi pe el.
Poate Jev AI să halucineze?
Modelul nu poate inventa un răspuns din afara listei tale, fiindcă doar alege dintre variantele date. Poate însă alege varianta greșită, uneori cu siguranță mare. De aceea contează pragul de încredere: peste el decide programul, sub el se uită un om.
Cum folosesc Jev AI din n8n?
Pentru n8n nu există încă un nod oficial pentru Jev, doar câteva noduri făcute de comunitate. Calea sigură e nodul HTTP Request, cu cererea trimisă direct la API-ul TypeSafe, la OpenRouter sau la Cloudflare și cu întrebările scrise în JSON, formatul de date pe care îl citesc programele.
